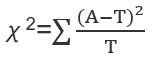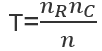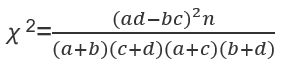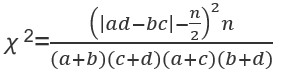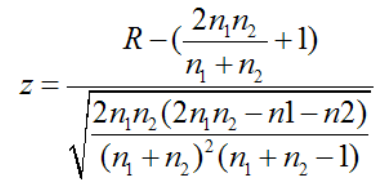
聚类分析与判别分析.医学统计实例详解

聚类分析与判别分析都属于分类问题的统计方法,但两者的出发点不同。聚类分析在没有先验类别信息的情况下,把相似的研究对象或变量归到同一类,属于无监督学习;判别分析则是在已知类别的前提下,建立判别规则,用于判断新对象属于哪一类,属于有监督学习。在医学研究中,聚类分析常用于探索疾病亚型或简化指标,判别分析常用于辅助诊断与预后分类。

方法说明

聚类分析按聚类对象分为两类:样本聚类称为Q型聚类,是把受试对象按多项指标聚成若干类,例如把患者分为不同亚型;变量聚类称为R型聚类,是把相关性高的变量归为一组,用于减少冗余指标。常见做法包括系统聚类(层次聚类)与K均值聚类。系统聚类按类间距离逐步合并,常用的类间距离定义有最短距离法、最长距离法、类平均法与Ward法;K均值聚类则需要先指定类别数K,通过反复迭代使类内平方和最小。

判别分析按前提条件可分为线性判别分析(LDA)与二次判别分析(QDA)。线性判别分析假设各类的协方差矩阵相等,并通常要求变量近似多元正态分布,据此建立线性判别函数;二次判别分析允许各类协方差矩阵不相等,判别边界为二次曲面,不需要组间协方差相等的假设,但需要估计的参数更多,对样本量要求也更高。

区别与前提条件

  • 聚类分析无先验类别,结果带有探索性;判别分析有先验类别,结果用于预测。聚类得到的分组可以作为判别分析的分类标签。
  • 聚类前必须对变量做标准化,否则量纲大或数值范围大的变量会主导距离计算。
  • K均值聚类需要事先确定K,可用轮廓系数辅助判断,其取值在-1到1之间,越接近1说明聚类内越紧密、类间越分离,一般取轮廓系数较大的K;也可用肘部法,观察类内平方和随K增大的下降拐点。
  • 线性判别分析要求各组协方差矩阵相等、变量近似正态,且样本量应大于变量个数;若各组协方差矩阵明显不等,应改用二次判别分析。
  • 判别效果不能只看回代正确率,回代容易高估,应结合留一交叉验证或独立样本验证。

医学实例

为探索2型糖尿病患者的代谢表型,某研究测量了24名患者的4项指标:空腹血糖(mmol/L)、糖化血红蛋白(%)、总胆固醇(mmol/L)、甘油三酯(mmol/L)。下表为原始数据(数值仅作示例)。

编号空腹血糖糖化血红蛋白总胆固醇甘油三酯
111.29.65.11.8
210.59.24.81.6
312.110.15.42.0
411.89.85.01.7
510.99.44.61.5
611.59.95.31.9
712.410.35.21.8
811.09.54.91.6
97.26.97.84.2
106.86.67.23.8
117.57.18.14.5
126.96.77.54.0
137.16.87.03.7
147.87.28.34.6
156.66.46.93.5
167.37.07.64.1
176.16.14.51.4
185.85.94.31.3
196.36.24.71.5
205.96.04.41.2
216.46.34.61.4
225.75.84.21.1
236.26.14.81.6
246.05.94.51.3

先对4项指标做标准化,再用K均值聚类。为确定类别数,分别取K=2至K=5计算轮廓系数,结果如下表。

K轮廓系数
20.58
30.84
40.73
50.61

K=3时轮廓系数最大,取3类。各类的中心(标准化前的均值)如下表。

类别空腹血糖糖化血红蛋白总胆固醇甘油三酯例数
第1类11.439.735.041.748
第2类7.156.847.554.058
第3类6.056.044.501.358

第1类以血糖显著升高为主,第2类以血脂升高为主,第3类各项指标相对平稳,提示该人群可能存在不同的代谢表型。进一步以这3类为分类标签,用4项指标建立线性判别分析,得到两个判别函数,用于评价这3类是否可以被有效区分。

判定与计算要点

  • 聚类常用的距离度量是欧氏距离,应在标准化后的数据上计算。
  • 系统聚类的类间距离定义会影响结果,Ward法倾向于得到大小较均匀的类,是较常用的选择。
  • K均值聚类对初始中心敏感,应多次随机初始化并取较优结果,或先用系统聚类确定初始分组。
  • 类别数可用轮廓系数、肘部法及专业可解释性综合确定,不宜仅凭主观指定。
  • 线性判别分析可用Wilks' Lambda检验判别函数的统计学意义,其值越小说明组间差异越明显;判别效能常用回代正确率与交叉验证正确率评价。

结果解读

聚类结果显示,24名患者被分为3类,各类例数均为8,与数据中自然形成的3组相吻合。判别分析中,线性判别函数总体检验Wilks' Lambda<0.001,χ²=160.5,df=8,P<0.001,说明3类之间差异有统计学意义。回代正确率为100%(24/24),留一交叉验证正确率也为100%(24/24),说明用这4项指标可以较好地反映不同代谢表型之间的差异。本例是为便于说明原理而构造的数据,3类界限清晰,故两种正确率都很高;实际资料中类别之间常存在重叠,回代正确率往往高于交叉验证正确率,此时应以交叉验证的结果为准。若各类的协方差矩阵明显不相等,则应改用二次判别分析。

常见错误用法

  • 不做标准化就直接聚类,使数值范围大的变量主导结果。
  • 使用K均值聚类却不说明K是如何确定的,仅凭主观指定类别数。
  • 把聚类得到的类别当作客观存在的疾病分型,忽略其探索性和样本依赖性。
  • 把聚类分析与判别分析混为一谈,或对未知类别的数据直接套用判别分析。
  • 在各类协方差矩阵明显不相等时仍使用线性判别分析,或样本量很小时使用二次判别分析。
  • 只用同一批数据建立判别模型并计算回代正确率,未做交叉验证,导致效果被高估。

注意事项

聚类结果很大程度上取决于所选变量、距离度量与聚类方法,换一套变量或方法可能得到不同的分组,因此结论应结合专业知识判断,并通过多种方法互相印证。判别分析要求训练样本能代表总体,类别标签应准确、划分清晰;变量数相对样本量不能过多,否则模型不稳定。聚类得到的类别数并非越多越好,应兼顾类内一致性与类间分离度以及实际可解释性。聚类与判别常配合使用,先用聚类探索分组,再用判别分析建立分类规则并评估其区分能力。
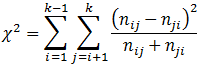
二元Logistic回归分析.医学统计实例详解

二元Logistic回归是一种用于分析二分类结局变量(如患病与未患病、有效与无效、存活与死亡)与一个或多个自变量之间关系的回归方法。当结局只有两种可能结果时,普通线性回归不再适用:它可能预测出概率范围以外的数值,残差也不再满足方差齐性与正态性。Logistic回归对结局发生的概率作logit变换,把取值在0到1之间的概率映射到整个实数轴,从而建立自变量与结局概率之间的线性关系。

它的核心用途有两个:一是筛选与结局相关的危险因素或保护因素,二是估计各自变量对结局发生优势的效应大小。队列研究、病例对照研究和横断面研究都可以使用,特别适合结局为二分类的资料。

一、模型形式与效应指标

设结局发生的概率为P,模型为 ln[P/(1-P)] = β0 + β1X1 + β2X2 + … + βmXm。回归系数βi表示自变量Xi每改变一个单位时,logit(P)的平均改变量。把βi取指数即为优势比 OR=exp(βi),它表示在其他自变量保持不变的条件下,Xi每增加一个单位,结局发生的优势(odds)变为原来的多少倍。OR大于1提示危险因素,小于1提示保护因素,等于1提示无关联。

OR是条件优势比,并不等同于相对危险度。当结局发生率较低(通常低于10%)时,OR可以近似看作相对危险度;结局较常见时二者差别明显,此时不宜把OR直接解释为风险倍数。

二、应用条件

  • 因变量为二分类变量,通常把关注的事件编码为1、未发生编码为0。
  • 各观测相互独立,一般不适用于重复测量或聚集性数据,这类资料需考虑其他模型。
  • 自变量与logit(P)之间呈线性关系;连续变量线性关系不明显时,可考虑引入多项式项或样条。
  • 自变量之间不存在严重多重共线性,否则系数估计不稳定。
  • 样本量充足。经验法则为每个纳入模型的自变量至少对应10个结局事件(EPV≥10),纳入变量越多,所需事件数越多。
  • 注意完全分离、稀疏数据和强影响点等问题。

三、医学实例

某研究纳入300例接受腹部手术的患者,随访30天,观察是否发生术后并发症(发生=1,未发生=0),其中发生并发症90例,未发生210例。考察的因素包括年龄、体质指数(BMI)、是否合并糖尿病和是否吸烟,变量赋值见表1。

变量赋值或单位
术后并发症0=未发生,1=发生
年龄连续变量,按每增加10岁
BMI连续变量,kg/m²,每增加1个单位
糖尿病0=无,1=有(以"无"为参照)
吸烟0=无,1=有(以"无"为参照)

本研究中结局事件为90例,纳入4个自变量,平均每个自变量对应22.5个事件,满足EPV≥10的经验要求。分类自变量糖尿病、吸烟均以"无"作为参照水平;年龄按每增加10岁、BMI按每增加1个单位进入模型。建立二元Logistic回归模型,结果见表2。

自变量β标准误Wald χ²POROR的95%CI
年龄(每10岁)0.5120.1867.580.0061.6681.158~2.403
BMI(每1个单位)0.1480.0615.890.0151.1601.029~1.307
糖尿病(有 vs 无)0.8740.3127.850.0052.3971.301~4.417
吸烟(有 vs 无)0.4210.2982.000.1571.5240.850~2.732
常数项-4.2130.84225.04<0.0010.015—

模型整体检验提示模型有意义,Hosmer-Lemeshow拟合优度检验 χ²=6.42,自由度8,P=0.600,P值大于0.05,提示模型拟合情况可以接受。以预测概率绘制受试者工作特征曲线,曲线下面积(AUC)约为0.78。

四、结果解读

年龄的OR为1.668(95%CI:1.158~2.403),P=0.006,说明在其他因素不变的条件下,年龄每增加10岁,发生术后并发症的优势约增加66.8%。BMI的OR为1.160(95%CI:1.029~1.307),P=0.015,说明BMI每增加1个单位,并发症发生优势约增加16.0%。糖尿病的OR为2.397(95%CI:1.301~4.417),P=0.005,提示合并糖尿病者并发症的发生优势约为无糖尿病者的2.4倍。吸烟的OR为1.524(95%CI:0.850~2.732),P=0.157,置信区间包含1,提示在本资料中吸烟与并发症的关联尚无统计学意义。

需要强调,OR对应的参照水平决定了解释方向。上例中糖尿病的OR是"有糖尿病相对于无糖尿病",若把参照水平改为"有",OR将变为原来的倒数(约0.417)。因此各自变量的参照水平必须在结果中明确写出。

当自变量较多时,可先做单因素分析,再把有意义的变量纳入多因素模型;但变量筛选不能只依赖P值,还要结合临床意义,避免遗漏重要混杂因素。若怀疑两个因素存在交互作用,可在模型中引入乘积项,此时乘积项的OR反映的是相对效应上的偏离程度,解释需谨慎,并报告交互项的检验结果。

五、常见错误用法

  • 把连续变量随意分组后建模,损失信息并可能引入虚假的阈值效应。
  • 忽视EPV经验法则,自变量过多导致过拟合,系数和OR不稳定。
  • 把OR当作相对危险度解释,尤其在结局较常见时夸大效应。
  • 不说明分类自变量的参照水平,导致OR含义不清。
  • 未检查多重共线性与线性假设,或对完全分离不作处理。
  • 对有缺失的数据直接删除,可能造成选择偏倚。

六、注意事项

Logistic回归给出的是关联而非因果,因果推断仍需依赖研究设计。模型报告应包含自变量的编码与参照水平、OR及其95%置信区间、模型整体检验以及拟合优度信息。自变量较多时,可结合临床意义与变量筛选策略确定最终模型,并在结果中如实报告。

Kappa系数与ICC组内相关系数.医学统计实例详解

在医学研究中,常需要评价不同观察者或不同测量方法之间的一致性,也就是结果是否可重复、可信。对于分类或等级资料,常用Kappa系数;对于连续变量,常用组内相关系数(ICC)。两者都衡量一致性,但适用资料类型与解释方式不同,不能混用。

一致性研究常见于诊断试验、量表评定和仪器测量等场景,是评估测量质量的重要环节。

一、Kappa系数

Kappa系数用于评价两名或多名评价者对同一对象进行分类判断时,实际一致程度是否超过了偶然一致。设有两名评价者,观察一致率为Po,由各行、各列边缘合计算出的期望一致率为Pe,则 Kappa=(Po-Pe)/(1-Pe)。Kappa的取值范围一般在-1到1之间:等于1表示完全一致,等于0表示一致程度与随机猜测相当,为负值表示实际一致低于偶然一致。Kappa同时考虑了实际一致与随机一致,因此比单纯计算一致率更能反映真实的判断水平。

对于有序等级资料,可使用加权Kappa,按等级差距赋予不同权重,能更合理地反映"差一级"与"差多级"的区别。多名评价者或多分类的情形,可用Fleiss Kappa等扩展形式。

二、Kappa的一致性分档

常用Landis与Koch提出的分档:小于0为差;0~0.20为极弱;0.21~0.40为一般;0.41~0.60为中等;0.61~0.80为较强;0.81~1.00为几乎完全一致。分档只是帮助理解的参考,一致性能否满足实际需要,还应结合具体指标与临床可接受标准判断。Kappa受患病率(边缘分布)影响较大,当某类别占比过高时,Kappa值可能偏低,此时应结合阳性一致率、阴性一致率等指标综合判断。

举例来说,两名评价者把结果分为轻、中、重三级,若一致格占比不高,加权Kappa会明显低于简单Kappa,但更符合"差距越大、惩罚越重"的直觉,因此对有序等级资料更为合适。报告加权Kappa时,应同时说明所用权重是线性权重还是平方权重。

三、医学实例:诊断一致性

两名医生用同一种影像方法对100例患者判断是否阳性(阳性/阴性),结果见表1。

医生B 阳性医生B 阴性合计
医生A 阳性55560
医生A 阴性73340
合计6238100

实际一致率 Po=(55+33)/100=0.88。期望一致率 Pe=(0.60×0.62)+(0.40×0.38)=0.372+0.152=0.524。Kappa=(0.88-0.524)/(1-0.524)=0.748,标准误约0.068,95%置信区间约为0.614~0.882。按分档标准,0.748属于较强一致,且置信区间不包含0,提示两名医生的判断一致性具有统计学意义,但仍未达到0.80以上,实际使用前宜进一步统一判读标准。

本例还可计算阳性一致率与阴性一致率:两名医生都判阳性的55例,占医生A所判60例阳性的91.7%;都判阴性的33例,占医生A所判40例阴性的82.5%。这两个指标从不同侧面反映一致性,报告时可与Kappa一并给出,以便读者判断不一致主要出现在哪一类。

四、ICC组内相关系数

ICC用于评价连续变量测量结果的一致性或信度,可理解为个体间差异占总变异的比例。当个体间的真实差异远大于测量误差时,ICC接近1。ICC有多种形式:单次测量还是多次测量的平均值、评价者视为固定还是随机、是否存在系统偏差,分别对应不同模型。报告时必须说明所用模型与计算方式,否则结果难以比较。

常参考的分档为:小于0.50为差;0.50~0.75为中等;0.75~0.90为良好;大于0.90为优。ICC同时受个体间变异与测量误差影响,样本的个体间差异过小会低估ICC,因此选入的受试对象应能覆盖目标人群的测量范围。

常见形式中,ICC(1,1)适用于每名受试者由不同评价者测量、评价者不固定且不要求系统偏差一致的情形;ICC(2,1)假定评价者是从更大评价者总体中随机抽取,允许存在系统偏差,结果可外推;ICC(3,1)把评价者视为固定,只关注当前这几名评价者的一致性。三者数值往往不同,研究目的决定了应选用哪一种。

五、医学实例:测量信度

两名医生分别用同一量表对20名患者的症状评分(0~100分)进行测量,数据见表2。

患者编号医生A医生B
15254
26159
34749
47068
55556
66361
74547
85860
96664
105052
117270
125755
134951
146466
155351
166869
174644
186062
195657
206260

采用双向随机效应的单次测量模型计算,ICC(2,1)=0.97(95%CI:0.95~0.98,P<0.001),提示两名医生的评分一致性为优。整体测量标准差约7.7分,按ICC折算的测量标准误约为1.3分,最小可检测变化约为3.6分,即评分变化小于该幅度时可能只是测量误差所致。

六、常见错误用法

  • 用Kappa评价连续变量的一致性,或用ICC评价分类资料。
  • 只报告Kappa或ICC数值,不说明所用模型、加权方式与置信区间。
  • 把一致性当作准确性:一致性高只说明结果可重复,不代表结果正确。
  • 受试对象个体间差异过小时计算ICC,得到偏低的信度。
  • Kappa接近0时直接断言"完全无关",忽视边缘分布的影响。
  • 用线性相关系数代替ICC评价一致性,相关系数对系统偏差不敏感。

七、注意事项

一致性研究应预先规定测量方法、评分标准与样本量,受试对象应覆盖目标人群的测量范围。Kappa与ICC都依赖研究样本,样本量越大,估计越稳定;报告置信区间有助于判断一致性的精度。此外,一致性只是测量学性质之一,还应结合重测信度、评定者间信度以及测量误差共同评价量表或仪器的表现。报告时宜同时给出原始一致率、Kappa及其95%置信区间,或ICC模型、数值及其95%置信区间,并结合专业标准判断一致性是否满足使用要求。

卡方检验医学实例2-配对列联表资料卡方检验

配对设计R*R的列联表资料(R>2)使用Bowker检验,当R=2时,等同于McNemar检验。 对于配对设计两分类资料,经典的方法是使用四格表的配对检验,也称McNemar检验。而对于配对设计多分类资料,可以使用Bowkor检验。该检验由A.H.Bowkor在1948年提出。Bowker检验也称平方表检验或对称检验,是McNemar检验的一般化及扩展。

一、Bowkor检验计算公式

自由度df=k(k-1)/2,如果有对称的两个单元格之和为0,则在公式中排除,自由度也相应的要减少。

二、医学应用实例

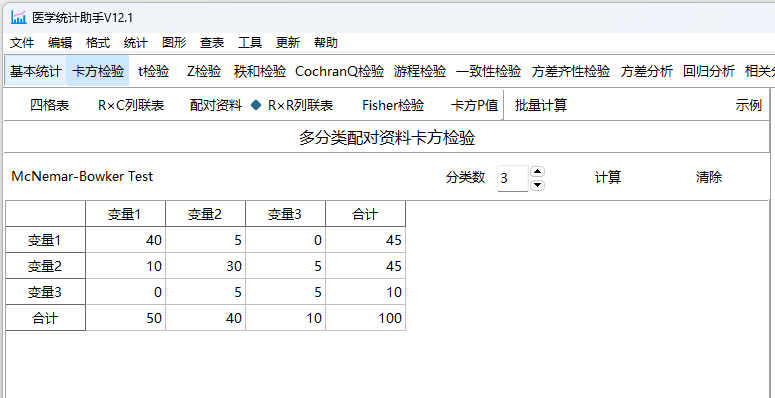
为了比较试剂A与试剂B在糖尿病检测中的有效性,我们招募了100名患者,并对他们使用试剂A和试剂B进行了糖尿病检测。这些检测结果被分为三类:阴性(未患病)、阳性(轻度患病)和重度阳性(重度患病)。以下是收集到的3x3数据表:

试剂B 阴性试剂B 阳性试剂B 重度阳性
试剂A 阴性4050
试剂A 阳性10305
试剂A 重度阳性055

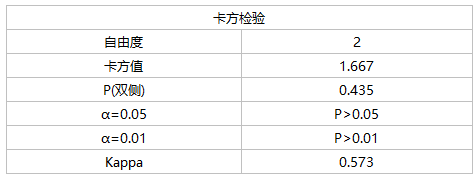
这个表格中的数据反映了试剂A和试剂B在不同患者群体中的表现。行表示试剂A的结果,列表示试剂B的结果。代入公式计算出卡方值等于1.67,因为有对称两个单元格之和等于0,所以自由度=(3*(3-1)/2)-1=2,查卡方界值表得P>0.05,表明两种试剂没有显著性差异。

三、使用软件计算配对列联表资料卡方检验

本软件提供该分析功能。

医学统计助手(www.statsas.com)

卡方检验医学实例1-四格表卡方检验

卡方检验(Chi-Square Test)是一种用于检验观察数据与理论预期之间差异是否显著的统计方法。在医学研究中,卡方检验特别适用于分析分类数据,例如疾病的发病率、治疗效果以及不同因素之间的关系。

一、卡方检验的原理

卡方检验用于判断观察到的频数与预期频数之间的差异是否显著。其基本假设是:观察到的分布与预期分布无显著差异,即变量之间没有关联。卡方统计量的基本公式为:

自由度df=(行数-1)(列数-1)

二、四格表(2x2表)的结构

四格表卡方检验基于一个二维表格,也称为四格表。表格中的行和列分别代表两个分类变量。例如,行可以代表男性和女性,列可以代表吸烟和不吸烟。表格中的每个单元格代表两个变量的交叉部分,例如男性吸烟者的数量。四格表卡方检验的目的是确定这些变量之间是否存在关联,如果存在关联,则表示两个变量之间有统计学上的显著性关系。

四格表,也称为2x2表,是卡方检验中最常用的数据格式。其结构如下:

事件A非事件A合计
事件Baba+b
非事件Bcdc+d
合计a+cb+dN

• 事件A 和 事件B 是两个分类变量。

• a, b, c, d 是不同组合的观察频数。

• N 是总样本量。

三、四格表专用公式

1.专用公式 N≥40 且T≥5

2.连续性矫正公式 N≥40 且1≤T<5

四、医学应用实例

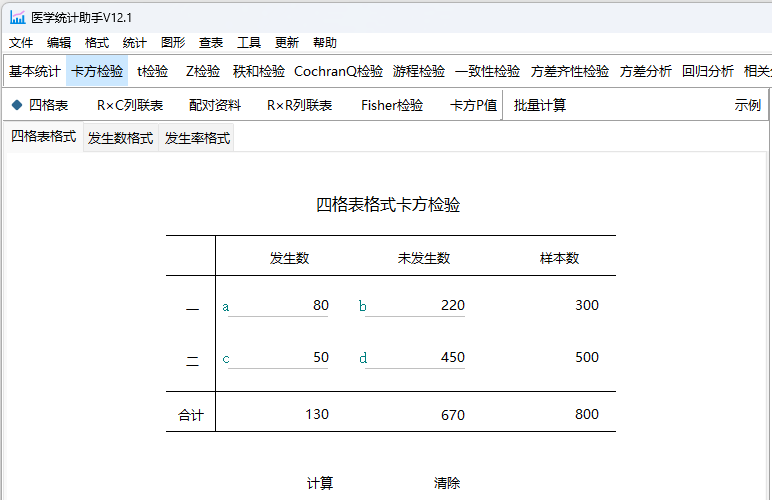
以下是一个关于吸烟与患肺癌的关系实例,展示了如何使用四格表卡方检验进行分析。研究对象是来自某地的300名吸烟者和500名非吸烟者。将它们整理成了一个四格表。表格如下所示:

患癌未患癌总数
吸烟80220300
不吸烟50450500
总数130670800

通过观察这个四格表,我们可以看到在吸烟患癌率比不吸烟患癌率高,但是这种观察不能证明吸烟与肺癌之间存在显著的关联。因此,需要使用四格表卡方检验来确定这种关联。

首先,需要计算每个单元格的期望值,即在假设吸烟与肺癌无关的情况下,每个单元格的预期人数。期望值计算公式为:期望值 = 行合计数 x 列合计数 / 样本总数。根据这个公式,计算得到期望值如下所示:

患癌未患癌总数
吸烟80220300
不吸烟50450500
总数130670800

符合N≥40 且T≥5,其中N为总样本量,T为最小期望值。可以使用四格表专用公式计算。

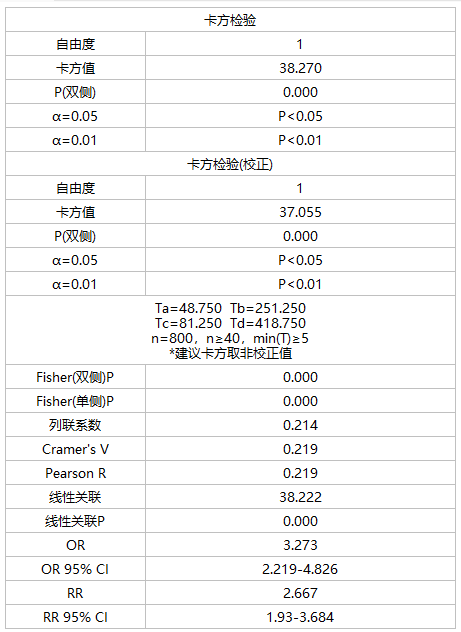
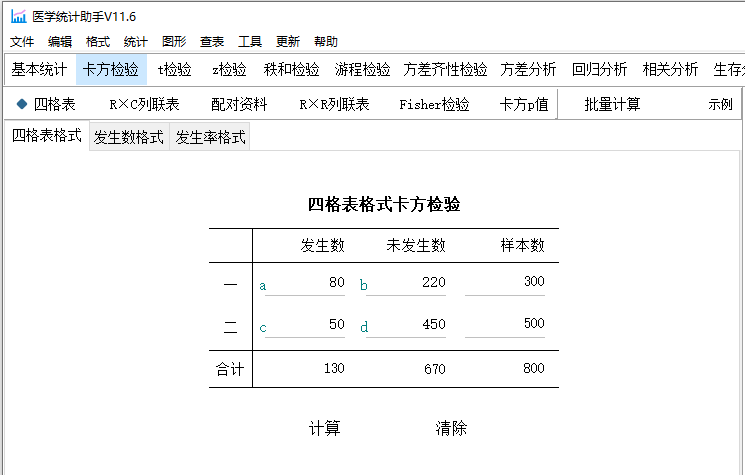
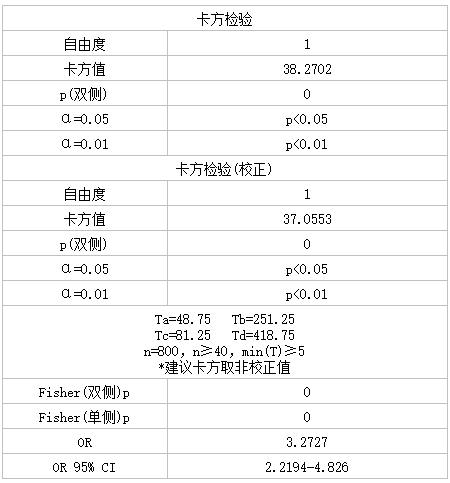
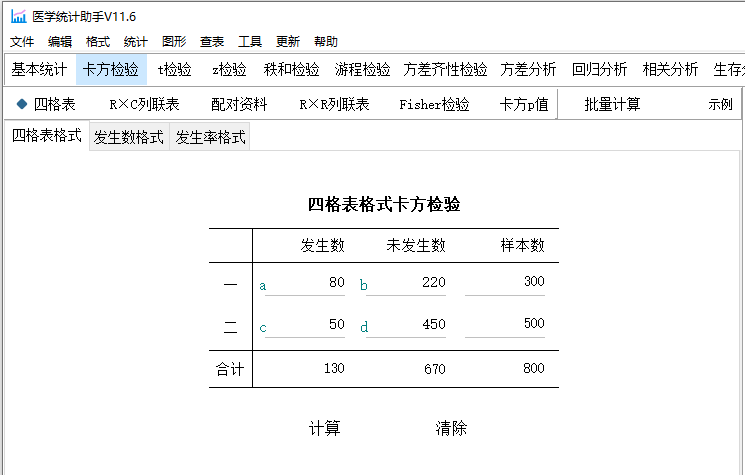
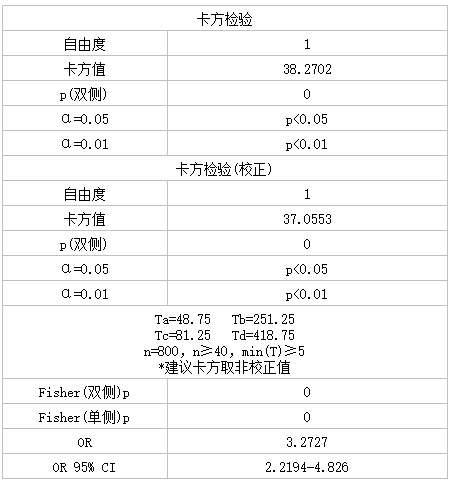
a=80,b=220,c=50,d=450,代入公式得卡方值等于38.27,自由度=(2-1)*(2-1)=1,查卡方界值表,P<0.01,这意味着,吸烟与肺癌之间存在显著的关联,也可以说吸烟与不吸烟存在显著性差异。具体来说,吸烟者的肺癌风险比非吸烟者高。这个结果表明,吸烟是肺癌的一个危险因素,可以用来指导肺癌的预防和治疗。

五、使用软件计算

本软件提供该分析功能。

医学统计助手(www.statsas.com)

Cochran Q检验.医学统计实例详解

Cochran Q检验是一种非参数统计方法,用于比较三个或更多相关样本中的二分类变量(如成功/失败、通过/未通过等)的比例。Cochran Q检验是Friedman检验在二分类情况下的特殊情况,它主要应用于重复测量设计或随机区组设计。Cochran Q检验旨在检测在不同条件下,受试者的二分类响应是否存在显著差异。

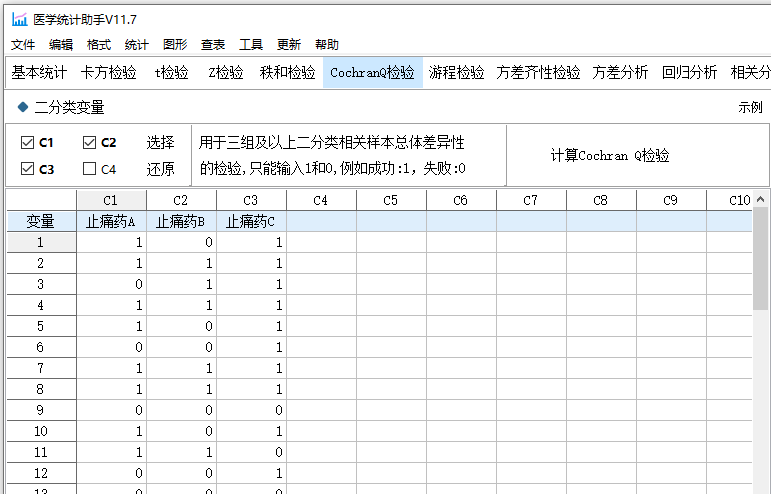
假设对比三种不同的止痛药对慢性头痛患者缓解症状的效果。随机选择了20名诊断为慢性头痛的患者。为了比较三种止痛药的效果,将每个患者分配到三个阶段的治疗,每个阶段为2周,中间有一个为期2周的洗脱期。三种止痛药包括:止痛药A、止痛药B、止痛药C。在每个阶段结束时,记录患者的头痛症状是否得到有效缓解(成功或失败)。1表示成功,0表示失败。表格中是收集到的数据。

为了确定三种止痛药的疗效有无显著性差异,可以使用Cochran Q检验计算Q值和P值。如果P值小于预先设定的显著性水平(例如0.05),就可以拒绝H0(所有止痛药的疗效相同),并得出结论:至少有一种止痛药的疗效与其他止痛药不同。

医学统计助手(www.statsas.com)

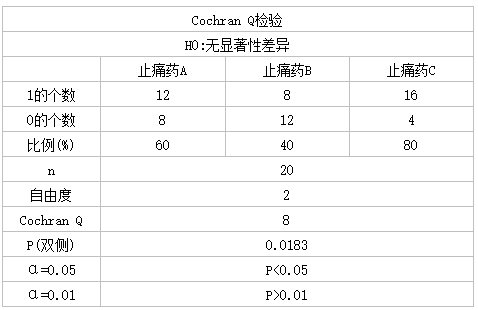
通过Cochran Q检验,发现止痛药存在显著差异(Q = 8,df = 2,p < 0.05)。进一步的多重比较分析显示,止痛药C的有效率(80%)显著高于止痛药A和止痛药B。

卡方检验结果怎么看

卡方检验(chi-squared test)是用于比较观察数据和期望数据之间的差异是否显著的一种统计方法。在进行卡方检验时,需要计算卡方统计量和p值,并将这些结果与显著性水平进行比较,来判断差异是否具有统计学意义。

卡方检验结果通常包括卡方统计量、自由度和显著性水平(P值):

  1. 卡方统计量:卡方统计量(chi-square statistic)是用于衡量观察数据和期望数据之间差异的量。卡方统计量的计算方式为,将每个观察值与对应的期望值之间的差异平方后除以期望值,然后将这些值加总。卡方统计量越大,表示观察数据与期望数据之间的差异越大。在进行卡方检验时,一般会计算卡方统计量,并将其与自由度一起用于查找卡方分布表以获取p值。
  2. 自由度:自由度(degrees of freedom)指的是进行卡方检验时可以自由变化的参数个数。在卡方检验中,自由度的计算方法为,自由度 = (行数 - 1) x (列数 - 1)。例如,如果进行2x2的卡方检验,则自由度为1。
  3. p值:p值(p-value)是用于判断差异是否具有统计学意义的重要指标。一般来说,P 值小于预先设定的显著性水平(如 0.05 或 0.01),则认为观察到的差异是显著的,拒绝零假设,认为观察数据和期望数据之间的差异具有统计学意义。反之,如果 P 值大于显著性水平,无法拒绝零假设,即观察到的差异可能是偶然产生的,认为观察数据和期望数据之间的差异不具有统计学意义。

计算结果如下。

卡方检验需要注意以下几点:

  1. 只适用于分类数据,不适用于连续数据。对于连续数据,可以考虑使用其他统计方法,如 t 检验、方差分析 或相关分析等。
  2. 不能提供关系的方向和强度。卡方检验只能判断变量之间是否存在关系,但不能提供关系的具体信息。要了解关系的方向和强度,可以使用其他统计方法,如列联表中的 Cramer's V、Phi 系数或相关分析等。
  3. 对期望频数的要求。卡方检验的有效性依赖于期望频数的大小。一般来说,期望频数应至少为 5。如果部分单元格的期望频数过小,可以尝试合并类别或使用 Fisher 确切检验等其他方法。

卡方检验是一种常用的非参数统计方法,适用于分析分类数据。通过计算卡方统计量、自由度和 P 值,使用卡方检验方法可以判断分类变量之间是否存在显著关系。但卡方检验也有一定的局限性,需要结合实际问题和数据特点来选择合适的统计方法。

卡方检验常见错误用法

卡方检验是一种常用的统计学方法,主要用于检验分类变量之间的关系。然而,在实际应用中,有时会出现一些错误用法。以下是卡方检验中更详细的常见错误及如何避免它们:

1.样本量太小:卡方检验依赖于足够的样本量,以确保检验结果的准确性。如果观察次数太少,检验结果可能受到偶然因素的影响。通常建议每个单元格的期望计数至少为5。如果样本量较小,可以考虑使用Fisher精确检验等其他方法。

2.连续变量的错误使用:卡方检验主要用于分类变量,将连续变量简单地划分为类别可能会导致信息损失和误差。对于连续变量,应使用其他方法,如t检验、方差分析或相关分析。若要将连续变量用于卡方检验,可以使用合适的分箱策略,但要谨慎处理分箱边界。

3.独立性假设不满足:卡方检验要求观察值之间相互独立。如果数据具有层次结构或其他依赖关系,应使用其他方法,如Mantel-Haenszel检验。在实际应用中,务必确保数据满足独立性假设。

4.使用不恰当的卡方检验类型:卡方检验有多种类型,如卡方独立性检验、卡方拟合优度检验和卡方列联表检验。选择不当可能导致错误的结论。因此,在进行卡方检验之前,需要了解不同类型的卡方检验,以便选择适用于当前问题的检验方法。

5.多重比较问题:在同时对多个假设进行卡方检验时,可能会出现多重比较问题。这会导致第一类错误(误拒原假设)的概率增加。为解决这一问题,可以使用Bonferroni校正、Šidák校正或其他多重比较校正方法来调整显著性水平。

6.不能确定因果关系:卡方检验仅能确定变量之间是否存在关联,但不能确定因果关系。在解释结果时,需要谨慎对待,避免得出不成立的因果关系结论。为了确定因果关系,可以使用实验设计、回归分析等其他方法。

7.没有检查假设条件:卡方检验的适用性基于一定的假设条件,例如观测值的独立性、变量的分类属性等。在应用卡方检验前,务必检查这些假设条件是否满足,否则可能导致检验结果不准确。

8.忽略应用条件:卡方检验适用于从总体中随机抽取的样本。如果样本不是随机抽取的,检验结果可能受到偏见影响。因此,在进行卡方检验之前,请确保样本满足随机抽样的条件。

9.数据不符合列联表要求:卡方检验通常用于列联表中的数据。列联表应为两个以上的分类变量组成的交叉频数表。如果数据结构不符合这一要求,可能需要调整数据或使用其他检验方法。

10.结果解释不当:卡方检验的结果包括卡方值、自由度和p值。p值用于判断观察到的差异是否具有统计显著性。但是,统计显著性并不意味着差异在实际中有重要意义。在解释结果时,要注意区分统计显著性与实际意义。

11.使用卡方检验进行变量筛选:在多元分析中,可能误用卡方检验来筛选关联变量。这样做可能会导致未考虑到变量间的交互作用或混杂效应。建议使用逐步回归、LASSO等方法进行变量筛选。

为了避免上述常见错误,在应用卡方检验时,要充分了解其基本原理、假设条件和限制。这将有助于提高检验结果的准确性和可靠性。

样本含量的估算方法

样本含量是在进行研究时所需的样本大小或参与者数量。在研究设计中,样本含量的大小直接影响研究的统计功效和可靠性。样本含量的大小取决于多个因素,如研究目的、研究设计、效应或关系的大小和统计分析方法等。确定适当的样本大小可以确保研究的有效性,并最大程度地减少Ⅰ类错误和Ⅱ类错误的概率。

一、两类错误:

1.第一类错误(Ⅰ类错误)也称为α错误,指的是原假设是正确的,但被错误地拒绝了。举例来说,在法庭判案中,如果被告真的是无辜的,但法官错误地判定被告有罪,那么这就是一种第一类错误。置信度为1-α。

2.第二类错误(Ⅱ类错误)也称为β错误,指的是原假设是错误的,但被错误地接受了。举例来说,在法庭判案中,如果被告真的是罪犯,但法官错误地判定被告无罪,那么这就是一种第二类错误。检验效能又称把握度,为1-β。

二、样本含量的估计取决于4个条件:

1.假设检验的Ⅰ类错误概率α,α越小所需样本量越多,或者说置信度越大,置信区间估计的可靠性越好,相应所需样本含量越大。对于相同α,双侧检验比单侧检验所需样本含量多。

2.假设检验的Ⅱ类错误概率β,或检验效能(1-β),β越小或检验效能越大,所需样本含量越多,一般要求检验效能在0.80及以上。

3.处理因素的效应δ,或这说容许误差δ,即预计样本统计量(均值或率)与相应总体参数(μ或π)的最大相差控制在什么范围。δ越大,所需样本含量越小。

4.总体的相关信息,例如均数比较时,总体标准差σ越大,所需样本含量越多,率的比较时,总体率π越接近于0.50,所需样本含量越多。

三、使用软件估算样本含量:

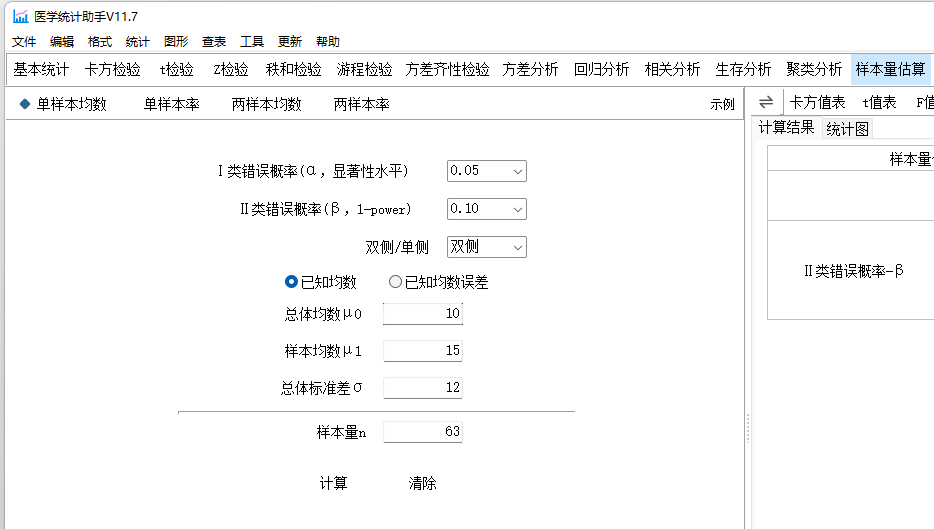
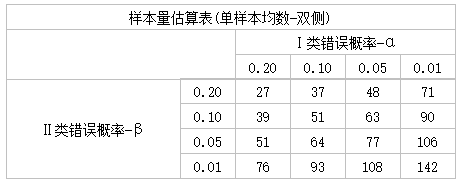
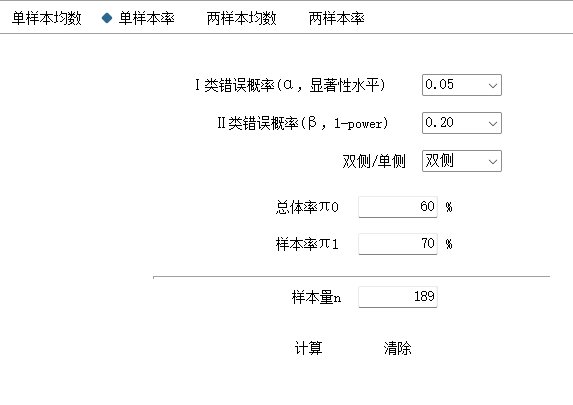
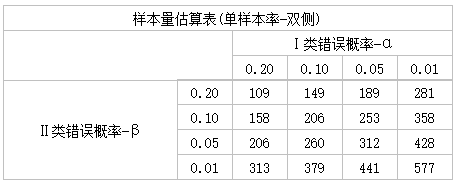
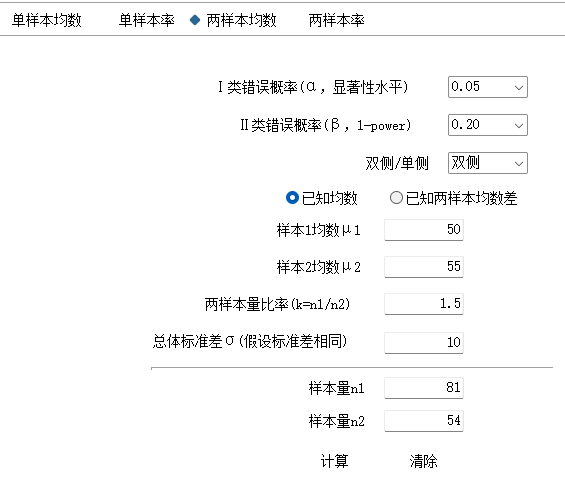
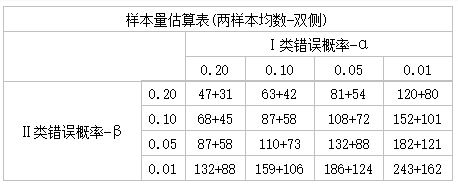
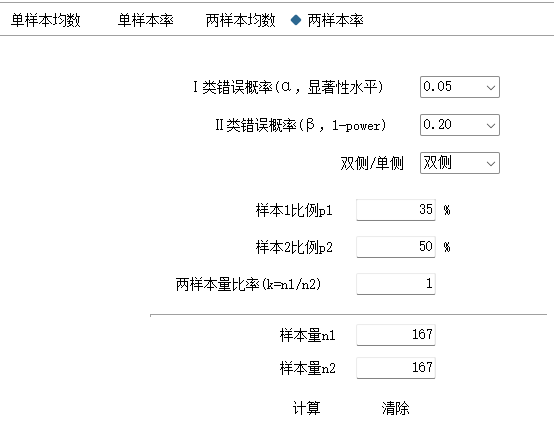
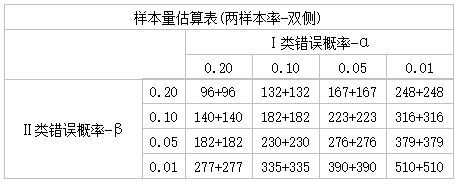
样本含量的计算方法包括单样本均数、单样本率、两样本均数、两样本率,不同方法可给出不同α和β水平下的参考结果。

1.单样本均数

2.单样本率

3.两样本均数

4.两样本率

游程检验.医学统计实例详解

游程检验是一种统计方法,用于检测数据序列中的随机性。在许多领域,如金融、气象学、生物学和社会科学等,都需要评估观测数据是否具有随机性。随机性是许多领域研究的基础。对数据序列的随机性进行检验有助于判断数据是否受到某种系统性影响,或者是否具有某种潜在的模式。游程检验是一种常用的随机性检验方法,其基本思想是分析数据序列中连续相同值的子序列的长度(即游程),以判断整个序列是否具有随机性。

一、游程检验在医学统计中的应用:

在医学统计中,评估数据序列的随机性具有重要意义。通过检验数据的随机性,可以判断实验结果是否受到某种系统性误差的影响,以及评估患者生理信号的稳定性和异常。例如实验设计、生物信号分析、疫情分析等等方面。

1.实验设计中的应用

在医学实验设计中,随机化是一种常用的方法,以消除潜在的误差和混杂因素。例如,在临床试验中,研究人员需要随机地将患者分配到不同的治疗组。游程检验可用于评估实验分组的随机性,以确保试验结果的可靠性。 通过对分组序列进行游程检验,可以判断实验分组是否符合随机的预期。若检验结果显示分组序列具有随机性,表明实验设计得当,结果可靠;反之,则可能需要重新设计实验方案。

2.生物信号分析中的应用

在医学研究中,生物信号(如心电图、脑电图等)的分析具有重要意义。通过评估生物信号的随机性,可以揭示患者生理功能的稳定性和异常,从而为诊断和治疗提供依据。 游程检验可用于评估生物信号中的局部随机性。例如,对心电图信号进行游程检验,可以判断心律失常的程度,以及心脏功能的稳定性。此外,游程检验还可以应用于脑电图信号分析,以评估神经系统的活动模式和异常。

3.疫情分析中的应用

在传染病疫情分析中,评估疫情数据的随机性具有重要意义。通过对疫情数据进行游程检验,可以判断疫情的发展 是否受到某种系统性影响,如公共卫生措施、季节变化等。这有助于研究人员评估疫情控制策略的有效性,以及预测疫情的发展趋势。

二、游程检验的理论和方法

游程是指数据序列中连续出现的相同值的个数。例如,在数据序列“1001110100”中,共有6个游程(1个1,2个0,3个1,1个0,1个1,2个0)。游程检验的基本假设是,在随机数据序列中,游程的数量和长度分布应该符合某种预期的概率分布。如果游程过多或者过少,都说明序列的随机性不好,例如序列1111100000或0101010101。

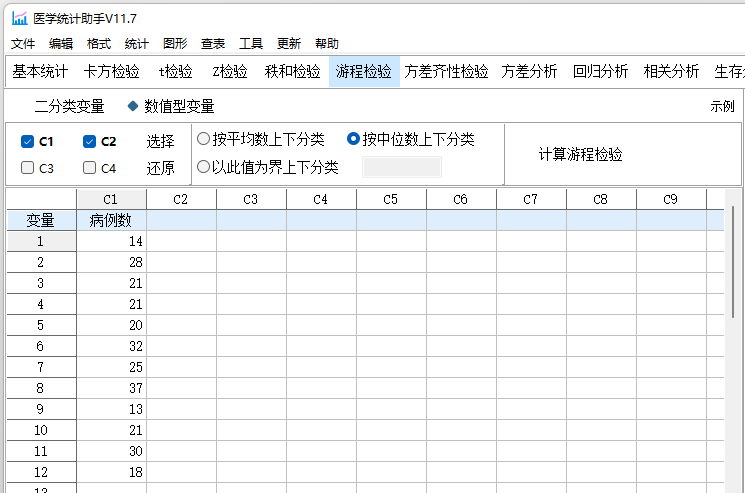
游程检验的步骤如下: 首先,需要将数据序列转换为二元序列。对于数值数据,可通过设定阈值(如中位数)将数据分为两类;对于分类数据,则直接使用原始编码。 检验统计量:计算检验统计量z,进行近似Z检验。其计算公式为

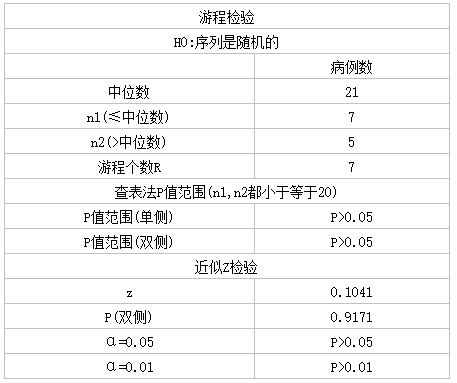
显著性检验:H0:序列是随机的。根据z值计算P值,以判断游程分布是否显著偏离随机情况。常用的显著性水平为0.05。若P值小于显著性水平,则拒绝原假设,认为数据序列可能非随机;若P值大于显著性水平,则不能拒绝原假设,认为数据序列可能具有随机性。

计算结果如下。

三、游程检验的限制和改进

尽管游程检验在医学统计中具有广泛的应用,但其局限性也不容忽视。例如,游程检验可能对数据序列的长度和分布敏感,这可能导致检验结果的不稳定。此外,游程检验只能检测数据序列中的局部随机性,而难以发现更复杂的非随机模式。为了克服这些限制,可以采取以下方法:

1. 引入自适应阈值:通过调整阈值,可以在不同的尺度上评估数据序列的随机性,从而提高游程检验的灵敏度。

2. 结合其他随机性检验方法:将游程检验与其他随机性检验方法(如谱分析、重标度范围分析等)结合,以获得更全面的数据序列特性评估。

3. 采用多尺度分析:通过在不同的时间尺度和空间尺度上进行游程检验,可以揭示数据序列的多层次随机性特征。