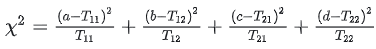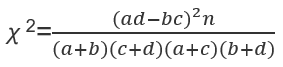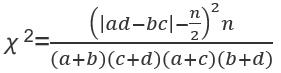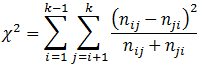医学统计助手.功能简介

最新版本:V17.1.2

发布日期:2026.09.02

医学统计助手,是专为医学统计而设计的专业统计分析软件,简单易用。功能涵盖基础统计、卡方检验、t检验、z检验、比例检验、秩和检验、Cochran Q检验、游程检验、一致性检验、方差齐性检验、方差分析、回归分析、相关分析、诊断试验评价、生存分析、Meta分析、聚类分析、判别分析、主成分分析、因子分析、问卷分析、随机数生成、批量分析和统计图等二十一大类实用功能。

一、软件特点
     界面简洁直观,输入数据、选择方法、点击计算,三步完成分析,无需编程基础。
     体积小,速度快,无广告,无插件,本地运行,激活后断网可用,不收集、不上传任何用户分析数据,数据仅保存在本机。

二、软件安装

      支持多种应用商店安装:微软Store、360软件管家、腾讯软件市场、联想应用商店等,或查看下载与安装说明。

三、主要功能
一、描述与基础统计

基础统计描述性统计量、缺失值、频数分布、正态分布、二项分布、泊松分布、样本量估算
随机数生成均匀、正态、卡方、t、F、Poisson、二项、指数、Gamma、负二项、Beta、Weibull、对数正态、均匀整数、伯努利、无放回抽样、有放回抽样(Bootstrap)、截断正态
计算器常规计算、医学计算

二、假设检验

卡方检验四格表、行×列表、配对资料、多分类配对资料、Fisher 精确检验、卡方 P 值
t 检验独立样本(汇总/原始)、配对样本、单样本(汇总/原始)、t 检验 P 值
Z 检验独立样本(汇总/原始)、配对样本、单样本(汇总/原始)、Z 检验 P 值
比例检验独立样本(汇总/原始)、配对样本、单样本(汇总/原始)
秩和检验配对、单样本、独立、等级资料、Kruskal-Wallis H、Friedman M
科克伦检验二分类 Cochran Q
游程检验二分类游程、数值变量游程
一致性检验Kappa、Kendall 协调系数、ICC 组内相关系数
方差齐性检验F、Levene、Brown-Forsythe、Bartlett、Fligner-Killeen

三、方差 / 回归 / 相关

方差分析完全随机设计、简易计算、随机区组、重复测量、多因素、协方差(ANCOVA)
回归分析线性、逐步、二分类 Logistic、有序 Logistic、泊松、负二项
相关分析Pearson 直线相关、Spearman 秩相关、Kendall 秩相关、偏相关

四、高级统计

生存分析Kaplan-Meier、寿命表法、生存率比较、Cox 回归
ROC 曲线ROC 曲线分析、多变量 AUC 比较、AUC 样本量估算
Meta 分析连续型变量(MD/SMD)、相关系数 r/z、OR、RR、RD、HR、AUC、单组比例、通用逆方差
聚类分析样本聚类、变量聚类、K 均值聚类
判别分析线性判别(LDA)、二次判别(QDA)
主成分分析PCA
因子分析主成分法、主轴因子法
问卷分析题型设置、数据概览、综合分析、交叉分析、量表综合分析

五、统计图表(25 种图形)

条形图、折线图、箱线图、小提琴图、山脊图、饼图、环形图、散点图、热力图、棒棒糖图、蜂群图、带状图、马赛克图、直方图、Q-Q 图、P-P 图、ECDF 图、哑铃图、面积图、雷达图、凹凸图、瀑布图、矩形树图、坡度图、意大利面图。
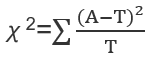
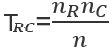
医学统计助手 V16.1 功能整理与软件评价

一、软件介绍

医学统计助手是一款专为医学科研、公共卫生及临床研究打造的统计分析软件。以经典医学统计学理论为基石,各项分析按标准统计学方法实现。

【专业全面】涵盖描述统计、假设检验、回归分析、生存分析等二十余类方法。支持t检验、卡方检验、秩和检验等假设检验;提供单因素、多因素、重复测量等方差分析;集成线性回归、Logistic回归、泊松回归等建模工具;包含Pearson、Spearman、Kendall等多种相关分析;支持Kaplan-Meier法、Cox回归等生存分析;具备聚类、判别、主成分、因子等多变量分析功能。

【问卷专属】独立的问卷分析模块,支持单选、多选、数值、量表、排序等题型设置,实现数据概览、综合统计、交叉分析、分层汇总及信效度检验,一站式完成问卷数据处理。

【可视呈现】内置条形图、折线图、箱线图、小提琴图、饼图、散点图、热力图、正态分布图等统计图表,支持编辑美化,助力成果展示。

【便捷安全】界面简洁直观,输入数据、选择方法、点击计算,三步完成分析,无需编程基础。本地运行,断网可用,不收集、不上传任何用户数据,数据仅保存在本机。

【持续服务】激活用户可免费升级至高版本,持续新增统计方法与功能优化。

二、功能模块整理

1. 基本统计功能(5项)

  • 描述性统计量
  • 缺失值处理
  • 频数分布
  • 正态分布检验
  • 样本量估算

2. 卡方检验(6项)

  • 四格表卡方检验
  • 行×列表卡方检验
  • 配对资料卡方检验(McNemar检验)
  • 多分类配对资料卡方检验(Bowker检验)
  • Fisher精确检验
  • 卡方P值计算

3. t检验(6项)

  • 独立样本t检验(汇总数据/原始数据)
  • 配对样本t检验
  • 单样本t检验(汇总数据/原始数据)
  • t检验P值计算

4. Z检验(6项)

  • 独立样本Z检验(汇总数据/原始数据)
  • 配对样本Z检验
  • 单样本Z检验(汇总数据/原始数据)
  • Z检验P值计算

5. 比例检验(5项)

  • 独立样本比例检验(汇总数据/原始数据)
  • 配对样本比例检验
  • 单样本比例检验(汇总数据/原始数据)

6. 秩和检验(6项)

  • 配对样本秩和检验
  • 单样本秩和检验
  • 两独立样本秩和检验
  • 等级资料秩和检验
  • Kruskal-Wallis H检验
  • Friedman M检验

7. 其他检验(2项)

  • 科克伦Q检验
  • 游程检验(二分类/数值型)

8. 一致性检验(3项)

  • Kappa系数
  • Kendall协调系数
  • ICC组内相关系数

9. 离散分布(2项)

  • 二项分布
  • Poisson分布

10. 随机数生成(1项)

11. 方差齐性检验(5项)

  • F检验
  • Levene检验
  • Brown-Forsythe检验
  • Bartlett检验
  • Fligner-Killeen检验

12. 方差分析(6项)

  • 完全随机设计方差分析
  • 简易计算方差分析
  • 随机区组设计方差分析
  • 重复测量设计方差分析
  • 多因素方差分析
  • 协方差分析

13. 回归分析(5项)

  • 线性回归
  • 逐步回归
  • 二元Logistic回归
  • Poisson回归
  • 负二项回归

14. 相关分析(4项)

  • Pearson相关
  • Spearman相关
  • Kendall相关
  • 偏相关

15. 生存分析(4项)

  • Kaplan-Meier法
  • 寿命表法
  • 生存率比较
  • Cox回归

16. 聚类分析(3项)

  • 样本聚类
  • 变量聚类
  • K均值聚类

17. 判别分析(2项)

  • LDA(线性判别分析)
  • QDA(二次判别分析)

18. 主成分分析(1项)

19. 因子分析(2项)

  • 主成分法因子分析
  • 主轴因子法因子分析

20. 问卷分析(6项)

  • 题型设置
  • 数据概览
  • 综合分析
  • 交叉表分析
  • 分层交叉分析
  • 量表信效度分析

21. 统计图(8类)

  • 条形图/柱状图
  • 折线图
  • 箱线图
  • 小提琴图
  • 饼图
  • 散点图
  • 热力图
  • 正态分布图(密度直方图、频数直方图、频率直方图、Q-Q图、P-P图)

22. 工具

  • 计算器
  • 随机数生成
  • 临界值查表

三、软件评价

✅ 优势

  1. 功能全面
  • 涵盖22个主功能模块,120+个明细功能
  • 从基础统计到高级多变量分析一应俱全
  • 特别适合医学科研、公共卫生、临床研究等领域
  1. 帮助文档完善
  • 每个功能都有详细的操作步骤
  • 包含方法说明、术语解释、应用条件
  • 提供结果解释和注意事项
  • 有实际应用场景说明
  1. 数据输入灵活
  • 支持汇总数据和原始数据两种输入方式
  • 支持多种数据格式(xlsx、csv等)
  • 问卷分析支持单选题、多选题、数值题、量表题、排序题
  1. 可视化丰富
  • 提供8大类统计图
  • 支持图表编辑和导出
  • 正态分布图提供5种子类型
  1. 统计方法严谨
  • 提供多种检验方法供选择(如方差齐性检验有5种方法)
  • 包含事后比较、多重比较校正
  • 提供效应量指标

⚠️ 局限性

  1. 版本限制
  • 部分功能显示"未激活版"
  • 可能存在功能或次数限制
  1. 学习曲线
  • 功能众多,初学者可能需要时间熟悉
  • 部分高级统计方法需要专业知识
  1. 数据要求
  • 某些分析对样本量有要求
  • 需要满足特定的统计假设

📊 适用人群

  • 临床医生、护士、药师等医疗专业人员
  • 医学科研人员、研究生
  • 公共卫生、流行病学研究人员
  • 医药企业研发人员
  • 医学院校师生

🎯 总体评价

医学统计助手 V16.1 是一款功能全面、专业性强的医学统计软件,特别适合医学科研领域使用。其优势在于:

  1. 功能覆盖全面:从基础描述统计到高级多变量分析,基本满足医学研究的各种统计需求
  2. 操作相对简便:提供详细帮助文档,降低使用门槛
  3. 结果输出规范:包含统计表格和可视化图表,便于论文撰写
  4. 方法选择多样:同一分析目的提供多种方法选择

建议:

  • 初学者建议从基础统计功能开始学习
  • 使用前应了解各统计方法的应用条件
  • 复杂分析建议咨询专业统计人员
  • 注意样本量要求和数据质量

以上为开发者自行整理的功能说明与自评,非第三方评测。

本文所述功能与适用范围以软件实际版本为准,请结合自身研究需求判断是否适用。

卡方检验计算公式

      卡方检验应用于两个率或两个构成比比较;多个率或多个构成比比较以及分类资料的相关分析等。 分类为独立样本卡方检验和配对样本卡方检验,独立样本卡方检验包括四格表卡方检验和行乘列卡方检验, 配对样本卡方检验分为四格表形式的配对资料卡方检验和R×R列联表卡方检验。
一、四格表卡方检验
四格表卡方检验是卡方检验中最常使用的方法。四格表即2×2列联表,表内有a、b、c、d4个基本数据,其余数据均由此4个数据推算出来的,故称为四格表资料。如下表。

组别达标未达标合计
对照组aba+b
实验组cdc+d
合计a+cb+dn


1.基本公式

A表示实际频数,T表示理论频数。

计算过程:

 𝑇𝑅𝐶 表示第R行第C列的理论(期望)频数,𝑛𝑅 表示第R行合计, 𝑛𝐶 表示第C列合计,n表示总合计。例如第一个单元格,为第1行第1列,实际频数a,理论频数,同理,,。

代入基本公式

自由度df=(行数-1)(列数-1)=(2-1)(2-1)=1

2.专用公式

N≥40 且最小理论频数T≥5

3.连续性矫正公式

N≥40 且最小理论频数1≤T<5

4.n<40或最小理论频数T<1用Fisher精确检验,又叫确切概率检验

      在计算小样本的P值时,不能根据卡方检验公式计算,可以使用Fisher精确检验直接计算出P值,Fihser精确检验只适用于计算小样本计数资料。

二、行乘列R×C格式卡方检验公式
      行乘列卡方检验时,要求不能有20%以上的单元格理论频数小于5,或者不能有任意一个单元格理论频数小于1,否则容易出现偏差。

1.计算行乘列卡方检验可以使用基本公式

因该式需要计算大量理论频数 𝑇𝑅𝐶 较为繁琐,所以一般使用专用公式计算行乘列卡方检验。

2.专用公式

自由度df=(行数-1)(列数-1)

三、配对资料卡方检验公式
      配对资料也可以分为定量资料和定性资料,在定量资料中,如果数据符合正态分布的话,一般使用配对t检验,如果不符合正态分布, 一般使用Wilcoxon符号秩和检验。在定性资料中,又可以分为配对四格表资料和RxR列联表资料,配对四格表资料一般应用McNemar卡方检验, RxR列联表资料一般应用McNemar-Bowker卡方检验。
配对四格表卡方检验公式:
1.b+c≥40

2.b+c<40

连续矫正公式

自由度df=1

四、配对资料R×R列联表卡方检验公式

      配对设计R×R的列联表资料(R>2)使用McNemar-Bowker检验(麦克尼马尔-鲍克检验),当R=2时,等同于McNemar检验。 对于配对设计两分类资料, 经典的方法是使用四格表的配对检验,也称McNemar检验。而对于配对设计多分类资料,可以使用McNemar-Bowker检验。该检验由A.H.Bowkor在1948年提出。 Bowker检验也称平方表检验或对称检验,是McNemar检验的一般化及扩展。

自由度df=k(k-1)/2,如果有对称的两个单元格之和为0,则在公式中排除,自由度也相应的要减少。

五、卡方检验p值计算公式

卡方检验P值就是卡方分布的分布函数值,计算公式为:

公式中分子为不完全伽马函数,分母为伽马函数。
分母中伽马函数需要使用斯特林公式来近似求伽马函数:

分子中不完全伽马函数计算公式:

其中M函数是合连几何函数,计算公式:

网页内容为作者收集整理创作,转载引用请附上本网址链接。

使用软件计算卡方检验

      《医学统计助手》主要功能:基本统计、卡方检验、t检验、z检验、秩和检验、游程检验、方差齐性检验、方差分析、回归分析、相关分析、生存分析、聚类分析、离散分布、样本量估算、随机数和统计图等功能。

医学统计助手(www.statsas.com)

主成分分析与因子分析.医学统计实例详解

主成分分析与因子分析都是处理多个相关变量的多元统计方法,常用于降维和探索变量之间的内在结构。当一项研究同时测量了许多彼此相关的指标时,这些指标往往存在信息重叠,直接拿它们建模或比较会带来麻烦。主成分分析和因子分析可以把大量相关的原始变量浓缩为少数几个综合指标,从而简化数据结构,便于后续分析。

方法说明与两者的区别

主成分分析(Principal Component Analysis,PCA)是一种降维方法。它把原始变量通过线性组合转换成少数几个互不相关的新变量,称为主成分,第一个主成分方差最大,依次递减,各主成分之间正交。主成分是原始变量的线性组合,属于对现有信息的重新表达,并不假设背后存在不可观测的变量。

因子分析(Factor Analysis)是一种探索潜在结构的方法。它假设各原始变量由少数几个不可直接观测的公共因子加上各自特有的特殊因子共同决定,通过分析变量之间的相关性来找出这些公共因子,并给出因子载荷,用以解释变量间相关的来源。

两者常被放在一起讨论,但目的并不相同:主成分分析回答的是“如何用更少的综合指标概括原有信息”,因子分析回答的是“变量之间为什么会相关,背后有哪些潜在维度”。在做法上也有差异:主成分分析通常不做旋转;因子分析常配合方差最大正交旋转,使因子载荷更易解释,且只解释变量间的共同方差。

应用场景与前提条件

当研究涉及多个高度相关的连续变量时,例如一组血液生化指标或一组生理测量指标,希望从中提取综合指标用于评价或分型,就可以考虑这两类方法。常见用途包括构造综合评分、消除后续回归或判别分析中的多重共线性,以及探索量表或问卷的维度结构。

  • 变量应为连续变量或近似连续变量,分类变量不宜直接纳入。
  • 样本量一般建议不少于变量个数的5至10倍,样本过少时结果不稳定。
  • 各变量量纲或数量级不同时,必须先做标准化处理,否则量纲大的变量会主导结果,实践中通常基于相关系数矩阵进行分析。
  • 变量之间应存在一定相关性,否则降维没有意义,可用KMO检验和Bartlett球形检验判断。

医学实例

为评价代谢紊乱程度,某研究对15名受试者测量了5项指标:体重指数(BMI)、腰围(cm)、收缩压(mmHg)、甘油三酯(mmol/L)、空腹血糖(mmol/L)。数据如下表。

编号BMI腰围收缩压甘油三酯空腹血糖
124.3821211.325.02
228.6961422.356.31
322.1741151.054.68
431.21041582.867.05
526.4891331.785.62
629.8991502.546.64
723.5781191.164.85
827.9941382.216.08
925.2851271.475.24
1032.61081633.057.32
1121.8721120.964.51
1230.41011552.726.88
1324.9841251.395.11
1428.3951412.306.22
1526.8911361.925.78

本例为便于说明计算过程,样本例数较少,实际研究应按前述样本量要求纳入足够数量的受试对象。

由于5项指标量纲不同,先对数据做标准化,再基于相关系数矩阵进行分析。是否适合降维,先做KMO检验与Bartlett球形检验:KMO=0.78,Bartlett球形检验χ²=63.7,df=10,P<0.001,说明变量之间存在较强的相关,适合做主成分分析或因子分析。

各主成分的特征值与方差贡献率如下表。

主成分特征值方差贡献率(%)累积方差贡献率(%)
第一主成分3.4268.468.4
第二主成分1.0521.089.4
第三主成分0.265.294.6
第四主成分0.163.297.8
第五主成分0.112.2100.0

前两个主成分的特征值均大于1,累积方差贡献率为89.4%,已达80%以上,因此取两个主成分。两主成分的载荷如下表。

变量第一主成分第二主成分
BMI0.830.55
腰围0.840.54
收缩压0.82-0.38
甘油三酯0.83-0.38
空腹血糖0.82-0.38

第一主成分在各变量上的载荷均为同向且数值较高,反映的是整体代谢紊乱程度,可解释为综合代谢因子;第二主成分在BMI、腰围上为正,在血压、血脂、血糖上为负,反映体型与代谢指标之间的相对关系。若改用因子分析并做方差最大正交旋转,通常可得到两个更易命名的公共因子:一个在血压、甘油三酯、空腹血糖上载荷较高,另一个在BMI、腰围上载荷较高,分别对应“代谢因子”与“肥胖因子”。

判定与计算要点

  • KMO反映变量间的偏相关程度,一般以大于0.6为可接受、大于0.7为较好;Bartlett球形检验P值小于0.05,说明变量间存在相关,可继续分析。
  • 主成分个数常按特征值大于1选取,或按累积方差贡献率达到80%以上选取,也可结合碎石图的拐点判断;不同准则结论不一致时,应结合专业可解释性取舍。
  • 载荷的绝对值越大,说明该变量对该主成分或公共因子的贡献越大,通常以0.5以上作为有意义的参考标准。
  • 因子分析中,变量的共同度反映公共因子对该变量的解释比例,共同度过低的变量可考虑剔除。

结果解读

本例中,前两个主成分累积解释了89.4%的总方差,即5个原始指标的信息可以用两个综合指标概括,信息损失较少。第一主成分得分越高,提示受试者的代谢紊乱越明显;第二主成分得分则刻画体型与代谢指标之间的相对偏离。

常见错误用法

  • 不先标准化就直接分析,导致量纲大的变量主导结果。
  • 把主成分当作客观存在的潜变量去解释,混淆了主成分分析与因子分析的目的。
  • 不做KMO与Bartlett球形检验,对相关很弱甚至不相关的变量盲目降维。
  • 为了凑够80%的累积方差贡献率而纳入大量主成分,失去了降维的意义。
  • 把分类变量直接纳入分析,或样本量远小于变量个数。

注意事项

主成分分析与因子分析的结果会受样本构成和变量选择的影响,变量增删后主成分结构与载荷可能改变,因此结论应结合专业知识判断。因子分析得到的公共因子是统计上的潜变量,命名时需要结合变量的实际含义。对同一批数据反复尝试不同的旋转方式或主成分个数,直到得到想要的结论,属于不当做法。

重复测量方差分析.医学统计实例详解

重复测量方差分析(Repeated Measures ANOVA)用于分析同一批受试对象在不同时间点或不同条件下重复测量所得到的资料。它是医学研究中很常见的一类设计:例如对同一位患者,在治疗前、治疗中、治疗后多次测量血压或某项血液指标,每个对象会被测量多次。这类数据的各个观测值之间并不独立,同一个体的多次测量往往相互关联,因此不能简单地按完全随机设计处理。

方法说明与两类因素

重复测量方差分析把变异来源分为组内因素、组间因素以及它们的交互作用。

  • 组内因素(within-subject factor),又称被试内因素,是每个受试对象都要经历其全部水平的因素,最典型的就是时间,如治疗前、第4周、第8周、第12周。
  • 组间因素(between-subject factor),又称被试间因素,是不同对象归属于不同水平的因素,例如试验药组与对照组,每个对象只属于其中一个水平。
  • 交互作用反映的是组间因素各组的指标随时间变化的趋势是否相同。

与普通方差分析相比,重复测量方差分析的关键区别在于:同一对象的多次测量构成一个区组,数据存在相关性,如果把重复测量当作独立样本处理,会低估误差、使检验变得过于敏感,从而增加假阳性。因此,当同一对象被反复测量时,应使用重复测量方差分析而不能用完全随机的方差分析。

前提假设

  • 正态性:各处理水平下或残差近似服从正态分布。
  • 方差齐性:组间因素各组之间方差齐同。
  • 球对称假设(sphericity):组内因素任意两个水平之间差值的方差相等,等价于各水平两两比较时差值方差相同。该假设用Mauchly检验来判断。
  • 当存在组间因素时,还要求各组间协方差矩阵相同,可用Box M检验辅助判断。

球对称假设是重复测量方差分析中最容易被忽略的一条。如果球对称成立,组内效应的F检验是精确的;如果违反,未校正的F检验会偏大,P值偏小。

医学实例

某研究比较两种降压药对收缩压的疗效,将60名高血压患者随机分为试验药组与对照组,每组30人,分别在治疗前(基线)、第4周、第8周、第12周测量收缩压(mmHg)。组间因素为药物(2个水平),组内因素为时间(4个水平)。各时间点收缩压的均数与标准差如下表。

组别基线第4周第8周第12周
试验药组(n=30)152.4±10.2141.6±9.8133.2±9.1128.5±8.7
对照组(n=30)151.8±10.5146.2±10.0141.3±9.6138.7±9.4

先做球对称检验:Mauchly W=0.79,χ²=13.54,df=5,P=0.019,小于0.05,说明不满足球对称假设,需要对组内效应的自由度进行校正。常用的校正方法有Greenhouse-Geisser校正与Huynh-Feldt校正,本例ε估计值分别为0.78与0.86。

校正后重复测量方差分析结果如下表。

效应F值自由度P值
组间(药物)6.421, 580.014
组内(时间)未校正18.603, 174<0.001
组内(时间)GG校正18.602.34, 135.72<0.001
时间×药物 未校正4.853, 1740.003
时间×药物 GG校正4.852.34, 135.720.008

由结果可见:组间因素药物主效应有统计学意义(F=6.42,P=0.014),总体上试验药组血压低于对照组;组内因素时间主效应显著(F=18.60,P<0.001),血压随治疗推进下降;时间与药物的交互作用也显著(P=0.008),说明两组血压随时间下降的趋势并不相同,试验药组下降幅度更大。由于交互作用显著,进一步做简单效应分析会更清楚地说明在哪些时间点上两组存在差异。

判定与计算要点

  • 球对称检验以Mauchly检验为主,P值大于0.05时可认为满足球对称,直接采用未校正结果。
  • 违反球对称时,应对组内效应的自由度乘以校正系数ε。ε取值范围为自由度分之一到1之间,ε越小说明偏离球对称越严重。
  • Greenhouse-Geisser校正较为保守,即ε估计偏小、P值偏大,一般当ε小于0.75时优先采用;Huynh-Feldt校正相对宽松,当ε接近1时与之接近。当ε等于1时,两种校正与未校正结果一致。
  • 校正只改变F检验的自由度和P值,F值本身不变。
  • 交互作用显著时,应做简单效应分析;单一指标的多时间点比较还可配合多重比较校正。

结果解读

本例中药物治疗是有效的:试验药组与对照组在第12周的收缩压分别为128.5±8.7与138.7±9.4,试验药组下降约23.9mmHg,对照组下降约13.1mmHg。药物主效应P=0.014说明两组总体存在差异,时间×药物交互作用P=0.008说明两组的下降趋势不同,即药物效果随治疗时间逐渐显现。由于球对称假设被违反,报告结果时应给出校正后的自由度与P值,而不是直接使用未校正的结果。

常见错误用法

  • 把重复测量数据当成独立样本做完全随机方差分析,忽视同一对象多次测量之间的相关性。
  • 把时间作为组间因素而不是组内因素,导致设计类型判断错误。
  • 不做球对称检验,直接报告未校正结果,尤其当时间点较多时更易出现问题。
  • 只用两两t检验比较各个时间点,既未控制多重比较,也未考虑数据的相关性。
  • 对缺失值随意填补或直接删除整个对象,影响结果的代表性。

注意事项

重复测量设计的时间点越多,球对称假设越容易被违反,因此更应重视Mauchly检验与校正。当球对称严重违反、校正后仍难以处理,或组内因素水平较多时,也可考虑采用多元方差分析的思路或混合效应模型,以更灵活地处理相关结构。各组样本量最好接近,缺失数据应尽量说明其模式与处理方式。结果的解释要符合临床意义,收缩压下降幅度虽然具有统计学意义,还应结合不良事件、耐受性等综合判断疗效。

生存分析.Kaplan-Meier法与Cox回归医学统计实例详解

生存分析是研究从某一时间起点到关注事件发生所经历时间的一类统计方法,广泛用于肿瘤随访、器官移植、慢性病预后等研究。与普通方法相比,它有两个特点:一是结局不仅包含事件是否发生,还包含事件发生的时间;二是随访过程中常出现删失数据。

把事件时间纳入分析,可以提高信息利用效率,也能正确处理随访时间长短不一的情况。

一、生存时间与删失数据

生存时间指从起点到事件发生所经历的时间。起点必须明确且统一,例如确诊日期或手术日期;事件可以是死亡、复发、疾病进展等。删失是指随访结束时仍未观察到关注事件,最常见的形式是右删失:受试者在研究终止时仍存活,或中途失访。删失个体的生存时间只提供了"至少活到该时刻"的信息,处理时不能简单当作事件,也不能直接剔除。

生存分析的基本假设是删失与生存时间相互独立,即删失的原因不包含与预后相关的信息。若失访者与继续观察者的预后明显不同,结果可能产生偏倚。

二、Kaplan-Meier法与Log-rank检验

Kaplan-Meier法又称乘积极限法,用于估计生存函数S(t),即在时刻t仍未发生事件的概率。它按事件发生的时间点逐步计算条件生存概率并累乘,得到阶梯状的生存曲线。当随访中存在删失时,每个时间点参与"风险集"的人数相应减少,Kaplan-Meier法正是针对这种情形设计的。中位生存期是使生存函数首次降至0.5所对应的时间;若曲线始终未降到0.5,则无法从该资料估计中位生存期。

比较两组或多组生存曲线常用Log-rank检验,其零假设为各组生存分布相同。该检验对整条曲线上的差异较敏感,尤其适合比例风险成立的情形。

三、Cox比例风险回归

Cox回归可以同时分析多个因素对生存时间的影响。其风险函数写作 h(t)=h0(t)·exp(β1X1+…+βmXm),其中h0(t)是不指定具体形式的基准风险,这也是它被称为半参数模型的原因。exp(βi)即风险比HR,表示其他变量保持不变时,Xi每增加一个单位,事件发生的瞬时风险变为原来的多少倍。HR大于1为危险因素,小于1为保护因素。

Cox回归的前提是比例风险假定,即任意两组的风险比不随时间改变,可用Schoenfeld残差等方法检验。若假定不成立,可引入时依协变量或改用分层Cox模型。

四、医学实例

某研究比较新疗法与标准治疗对某恶性肿瘤患者生存的影响,共随访120例患者,随访期最长60个月,主要终点为全因死亡。其中新疗法组60例,观察期间死亡24例;标准治疗组60例,死亡36例,其余为删失。按治疗方式绘制Kaplan-Meier曲线,主要结果见表1,Cox回归结果见表2。

组别例数死亡事件删失中位生存期(月)
新疗法组60243638.5
标准治疗组60362424.2
变量HR95%CIP
新疗法 vs 标准治疗(单因素)0.580.39~0.860.007
新疗法 vs 标准治疗(多因素)0.620.42~0.920.017
年龄(每增加10岁)1.311.08~1.590.006
分期 III~IV期 vs I~II期2.151.42~3.25<0.001

两组生存曲线在随访早期即出现分离。Log-rank检验 χ²=7.86,自由度1,P=0.005,提示两组生存分布差异有统计学意义。多因素Cox回归中,校正年龄与临床分期后,新疗法组死亡风险为标准化治疗组的0.62倍(HR=0.62,95%CI:0.42~0.92,P=0.017),相当于死亡风险降低约38%。分期较晚者死亡风险约为早期患者的2.15倍(95%CI:1.42~3.25,P<0.001)。比例风险假定检验的全局P值为0.31,大于0.05,提示假定成立。

五、结果解读

HR的解释必须结合变量单位与参照组。上例中新疗法相对标准治疗的HR为0.62,说明新疗法与更低的死亡风险相关;年龄按每10岁计算,HR为1.31,表示年龄每增加10岁,死亡风险约为原来的1.31倍。HR的95%置信区间不包含1且P值小于0.05,提示关联具有统计学意义。

中位生存期与中位随访时间含义不同:前者是生存曲线降到0.5对应的时间,描述的是生存结局;后者描述的是随访时间的集中趋势。两者不可混用,报告时也应写清各自定义。

除HR之外,生存分析还应结合生存曲线整体形态、事件发生的时间分布以及是否满足比例风险来综合判断。若某因素在随访早、晚期作用方向不同,提示可能存在非比例风险,单用Cox回归会掩盖这种变化,可采用时依协变量处理。

六、常见错误用法

  • 把删失当作事件处理,或直接删除删失个体,导致结果偏倚。
  • 用t检验或方差分析比较生存时间,忽略删失并违反分布假设。
  • 不检验比例风险假定就直接报告Cox回归结果。
  • 把HR写成相对危险度,或在忽略参照组与单位的情况下随意解释。
  • 只报告P值而不报告HR及其95%置信区间。
  • 把中位随访时间误当作中位生存期。

七、注意事项

生存分析要求起点与终点定义清晰、随访资料完整。曲线尾部涉及的人数较少时,生存曲线的估计不稳定,解释应谨慎。报告时宜同时给出各组例数、事件数、中位生存期、HR及其95%置信区间,并说明是否满足比例风险假定。

聚类分析与判别分析.医学统计实例详解

聚类分析与判别分析都属于分类问题的统计方法,但两者的出发点不同。聚类分析在没有先验类别信息的情况下,把相似的研究对象或变量归到同一类,属于无监督学习;判别分析则是在已知类别的前提下,建立判别规则,用于判断新对象属于哪一类,属于有监督学习。在医学研究中,聚类分析常用于探索疾病亚型或简化指标,判别分析常用于辅助诊断与预后分类。

方法说明

聚类分析按聚类对象分为两类:样本聚类称为Q型聚类,是把受试对象按多项指标聚成若干类,例如把患者分为不同亚型;变量聚类称为R型聚类,是把相关性高的变量归为一组,用于减少冗余指标。常见做法包括系统聚类(层次聚类)与K均值聚类。系统聚类按类间距离逐步合并,常用的类间距离定义有最短距离法、最长距离法、类平均法与Ward法;K均值聚类则需要先指定类别数K,通过反复迭代使类内平方和最小。

判别分析按前提条件可分为线性判别分析(LDA)与二次判别分析(QDA)。线性判别分析假设各类的协方差矩阵相等,并通常要求变量近似多元正态分布,据此建立线性判别函数;二次判别分析允许各类协方差矩阵不相等,判别边界为二次曲面,不需要组间协方差相等的假设,但需要估计的参数更多,对样本量要求也更高。

区别与前提条件

  • 聚类分析无先验类别,结果带有探索性;判别分析有先验类别,结果用于预测。聚类得到的分组可以作为判别分析的分类标签。
  • 聚类前必须对变量做标准化,否则量纲大或数值范围大的变量会主导距离计算。
  • K均值聚类需要事先确定K,可用轮廓系数辅助判断,其取值在-1到1之间,越接近1说明聚类内越紧密、类间越分离,一般取轮廓系数较大的K;也可用肘部法,观察类内平方和随K增大的下降拐点。
  • 线性判别分析要求各组协方差矩阵相等、变量近似正态,且样本量应大于变量个数;若各组协方差矩阵明显不等,应改用二次判别分析。
  • 判别效果不能只看回代正确率,回代容易高估,应结合留一交叉验证或独立样本验证。

医学实例

为探索2型糖尿病患者的代谢表型,某研究测量了24名患者的4项指标:空腹血糖(mmol/L)、糖化血红蛋白(%)、总胆固醇(mmol/L)、甘油三酯(mmol/L)。下表为原始数据(数值仅作示例)。

编号空腹血糖糖化血红蛋白总胆固醇甘油三酯
111.29.65.11.8
210.59.24.81.6
312.110.15.42.0
411.89.85.01.7
510.99.44.61.5
611.59.95.31.9
712.410.35.21.8
811.09.54.91.6
97.26.97.84.2
106.86.67.23.8
117.57.18.14.5
126.96.77.54.0
137.16.87.03.7
147.87.28.34.6
156.66.46.93.5
167.37.07.64.1
176.16.14.51.4
185.85.94.31.3
196.36.24.71.5
205.96.04.41.2
216.46.34.61.4
225.75.84.21.1
236.26.14.81.6
246.05.94.51.3

先对4项指标做标准化,再用K均值聚类。为确定类别数,分别取K=2至K=5计算轮廓系数,结果如下表。

K轮廓系数
20.55
30.68
40.54
50.47

K=3时轮廓系数最大,取3类。各类的中心(标准化前的均值)如下表。

类别空腹血糖糖化血红蛋白总胆固醇甘油三酯例数
第1类11.439.735.041.748
第2类7.156.847.554.058
第3类6.056.044.501.358

第1类以血糖显著升高为主,第2类以血脂升高为主,第3类各项指标相对平稳,提示该人群可能存在不同的代谢表型。进一步以这3类为分类标签,用4项指标建立线性判别分析,得到两个判别函数,用于评价这3类是否可以被有效区分。

判定与计算要点

  • 聚类常用的距离度量是欧氏距离,应在标准化后的数据上计算。
  • 系统聚类的类间距离定义会影响结果,Ward法倾向于得到大小较均匀的类,是较常用的选择。
  • K均值聚类对初始中心敏感,应多次随机初始化并取较优结果,或先用系统聚类确定初始分组。
  • 类别数可用轮廓系数、肘部法及专业可解释性综合确定,不宜仅凭主观指定。
  • 线性判别分析可用Wilks' Lambda检验判别函数的统计学意义,其值越小说明组间差异越明显;判别效能常用回代正确率与交叉验证正确率评价。

结果解读

聚类结果显示,24名患者被分为3类,各类例数均为8,与数据中自然形成的3组相吻合。判别分析中,线性判别函数总体检验Wilks' Lambda=0.24,χ²=27.8,df=8,P<0.001,说明3类之间差异有统计学意义。回代正确率为91.7%(22/24),留一交叉验证正确率为83.3%(20/24),说明用这4项指标可以在一定程度上区分不同代谢表型的患者。若各类的协方差矩阵明显不相等,则应改用二次判别分析。

常见错误用法

  • 不做标准化就直接聚类,使数值范围大的变量主导结果。
  • 使用K均值聚类却不说明K是如何确定的,仅凭主观指定类别数。
  • 把聚类得到的类别当作客观存在的疾病分型,忽略其探索性和样本依赖性。
  • 把聚类分析与判别分析混为一谈,或对未知类别的数据直接套用判别分析。
  • 在各类协方差矩阵明显不相等时仍使用线性判别分析,或样本量很小时使用二次判别分析。
  • 只用同一批数据建立判别模型并计算回代正确率,未做交叉验证,导致效果被高估。

注意事项

聚类结果很大程度上取决于所选变量、距离度量与聚类方法,换一套变量或方法可能得到不同的分组,因此结论应结合专业知识判断,并通过多种方法互相印证。判别分析要求训练样本能代表总体,类别标签应准确、划分清晰;变量数相对样本量不能过多,否则模型不稳定。聚类得到的类别数并非越多越好,应兼顾类内一致性与类间分离度以及实际可解释性。聚类与判别常配合使用,先用聚类探索分组,再用判别分析建立分类规则并评估其区分能力。

二元Logistic回归分析.医学统计实例详解

二元Logistic回归是一种用于分析二分类结局变量(如患病与未患病、有效与无效、存活与死亡)与一个或多个自变量之间关系的回归方法。当结局只有两种可能结果时,普通线性回归不再适用:它可能预测出概率范围以外的数值,残差也不再满足方差齐性与正态性。Logistic回归对结局发生的概率作logit变换,把取值在0到1之间的概率映射到整个实数轴,从而建立自变量与结局概率之间的线性关系。

它的核心用途有两个:一是筛选与结局相关的危险因素或保护因素,二是估计各自变量对结局发生优势的效应大小。队列研究、病例对照研究和横断面研究都可以使用,特别适合结局为二分类的资料。

一、模型形式与效应指标

设结局发生的概率为P,模型为 ln[P/(1-P)] = β0 + β1X1 + β2X2 + … + βmXm。回归系数βi表示自变量Xi每改变一个单位时,logit(P)的平均改变量。把βi取指数即为优势比 OR=exp(βi),它表示在其他自变量保持不变的条件下,Xi每增加一个单位,结局发生的优势(odds)变为原来的多少倍。OR大于1提示危险因素,小于1提示保护因素,等于1提示无关联。

OR是条件优势比,并不等同于相对危险度。当结局发生率较低(通常低于10%)时,OR可以近似看作相对危险度;结局较常见时二者差别明显,此时不宜把OR直接解释为风险倍数。

二、应用条件

  • 因变量为二分类变量,通常把关注的事件编码为1、未发生编码为0。
  • 各观测相互独立,一般不适用于重复测量或聚集性数据,这类资料需考虑其他模型。
  • 自变量与logit(P)之间呈线性关系;连续变量线性关系不明显时,可考虑引入多项式项或样条。
  • 自变量之间不存在严重多重共线性,否则系数估计不稳定。
  • 样本量充足。经验法则为每个纳入模型的自变量至少对应10个结局事件(EPV≥10),纳入变量越多,所需事件数越多。
  • 注意完全分离、稀疏数据和强影响点等问题。

三、医学实例

某研究纳入300例接受腹部手术的患者,随访30天,观察是否发生术后并发症(发生=1,未发生=0),其中发生并发症90例,未发生210例。考察的因素包括年龄、体质指数(BMI)、是否合并糖尿病和是否吸烟,变量赋值见表1。

变量赋值或单位
术后并发症0=未发生,1=发生
年龄连续变量,按每增加10岁
BMI连续变量,kg/m²,每增加1个单位
糖尿病0=无,1=有(以"无"为参照)
吸烟0=无,1=有(以"无"为参照)

本研究中结局事件为90例,纳入4个自变量,平均每个自变量对应22.5个事件,满足EPV≥10的经验要求。分类自变量糖尿病、吸烟均以"无"作为参照水平;年龄按每增加10岁、BMI按每增加1个单位进入模型。建立二元Logistic回归模型,结果见表2。

自变量β标准误Wald χ²POROR的95%CI
年龄(每10岁)0.5120.1867.580.0061.6681.158~2.403
BMI(每1个单位)0.1480.0615.890.0151.1601.029~1.307
糖尿病(有 vs 无)0.8740.3127.850.0052.3971.301~4.417
吸烟(有 vs 无)0.4210.2982.000.1571.5240.850~2.732
常数项-4.2130.84225.04<0.0010.015—

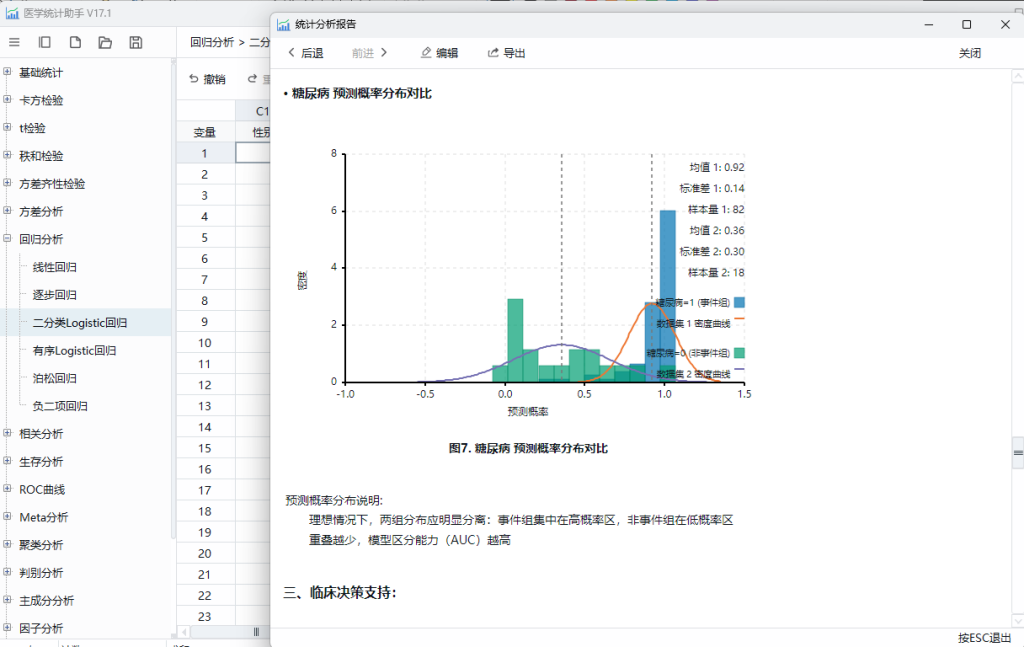
模型整体检验提示模型有意义,Hosmer-Lemeshow拟合优度检验 χ²=6.42,自由度8,P=0.600,P值大于0.05,提示模型拟合情况可以接受。以预测概率绘制受试者工作特征曲线,曲线下面积(AUC)约为0.78。

四、结果解读

年龄的OR为1.668(95%CI:1.158~2.403),P=0.006,说明在其他因素不变的条件下,年龄每增加10岁,发生术后并发症的优势约增加66.8%。BMI的OR为1.160(95%CI:1.029~1.307),P=0.015,说明BMI每增加1个单位,并发症发生优势约增加16.0%。糖尿病的OR为2.397(95%CI:1.301~4.417),P=0.005,提示合并糖尿病者并发症的发生优势约为无糖尿病者的2.4倍。吸烟的OR为1.524(95%CI:0.850~2.732),P=0.157,置信区间包含1,提示在本资料中吸烟与并发症的关联尚无统计学意义。

需要强调,OR对应的参照水平决定了解释方向。上例中糖尿病的OR是"有糖尿病相对于无糖尿病",若把参照水平改为"有",OR将变为原来的倒数(约0.417)。因此各自变量的参照水平必须在结果中明确写出。

当自变量较多时,可先做单因素分析,再把有意义的变量纳入多因素模型;但变量筛选不能只依赖P值,还要结合临床意义,避免遗漏重要混杂因素。若怀疑两个因素存在交互作用,可在模型中引入乘积项,此时乘积项的OR反映的是相对效应上的偏离程度,解释需谨慎,并报告交互项的检验结果。

五、常见错误用法

  • 把连续变量随意分组后建模,损失信息并可能引入虚假的阈值效应。
  • 忽视EPV经验法则,自变量过多导致过拟合,系数和OR不稳定。
  • 把OR当作相对危险度解释,尤其在结局较常见时夸大效应。
  • 不说明分类自变量的参照水平,导致OR含义不清。
  • 未检查多重共线性与线性假设,或对完全分离不作处理。
  • 对有缺失的数据直接删除,可能造成选择偏倚。

六、注意事项

Logistic回归给出的是关联而非因果,因果推断仍需依赖研究设计。模型报告应包含自变量的编码与参照水平、OR及其95%置信区间、模型整体检验以及拟合优度信息。自变量较多时,可结合临床意义与变量筛选策略确定最终模型,并在结果中如实报告。

Kappa系数与ICC组内相关系数.医学统计实例详解

在医学研究中,常需要评价不同观察者或不同测量方法之间的一致性,也就是结果是否可重复、可信。对于分类或等级资料,常用Kappa系数;对于连续变量,常用组内相关系数(ICC)。两者都衡量一致性,但适用资料类型与解释方式不同,不能混用。

一致性研究常见于诊断试验、量表评定和仪器测量等场景,是评估测量质量的重要环节。

一、Kappa系数

Kappa系数用于评价两名或多名评价者对同一对象进行分类判断时,实际一致程度是否超过了偶然一致。设有两名评价者,观察一致率为Po,由各行、各列边缘合计算出的期望一致率为Pe,则 Kappa=(Po-Pe)/(1-Pe)。Kappa的取值范围一般在-1到1之间:等于1表示完全一致,等于0表示一致程度与随机猜测相当,为负值表示实际一致低于偶然一致。Kappa同时考虑了实际一致与随机一致,因此比单纯计算一致率更能反映真实的判断水平。

对于有序等级资料,可使用加权Kappa,按等级差距赋予不同权重,能更合理地反映"差一级"与"差多级"的区别。多名评价者或多分类的情形,可用Fleiss Kappa等扩展形式。

二、Kappa的一致性分档

常用Landis与Koch提出的分档:小于0为差;0~0.20为极弱;0.21~0.40为一般;0.41~0.60为中等;0.61~0.80为较强;0.81~1.00为几乎完全一致。分档只是帮助理解的参考,一致性能否满足实际需要,还应结合具体指标与临床可接受标准判断。Kappa受患病率(边缘分布)影响较大,当某类别占比过高时,Kappa值可能偏低,此时应结合阳性一致率、阴性一致率等指标综合判断。

举例来说,两名评价者把结果分为轻、中、重三级,若一致格占比不高,加权Kappa会明显低于简单Kappa,但更符合"差距越大、惩罚越重"的直觉,因此对有序等级资料更为合适。报告加权Kappa时,应同时说明所用权重是线性权重还是平方权重。

三、医学实例:诊断一致性

两名医生用同一种影像方法对100例患者判断是否阳性(阳性/阴性),结果见表1。

医生B 阳性医生B 阴性合计
医生A 阳性55560
医生A 阴性73340
合计6238100

实际一致率 Po=(55+33)/100=0.88。期望一致率 Pe=(0.60×0.62)+(0.40×0.38)=0.372+0.152=0.524。Kappa=(0.88-0.524)/(1-0.524)=0.748,标准误约0.068,95%置信区间约为0.614~0.882。按分档标准,0.748属于较强一致,且置信区间不包含0,提示两名医生的判断一致性具有统计学意义,但仍未达到0.80以上,实际使用前宜进一步统一判读标准。

本例还可计算阳性一致率与阴性一致率:两名医生都判阳性的55例,占医生A所判60例阳性的91.7%;都判阴性的33例,占医生A所判40例阴性的82.5%。这两个指标从不同侧面反映一致性,报告时可与Kappa一并给出,以便读者判断不一致主要出现在哪一类。

四、ICC组内相关系数

ICC用于评价连续变量测量结果的一致性或信度,可理解为个体间差异占总变异的比例。当个体间的真实差异远大于测量误差时,ICC接近1。ICC有多种形式:单次测量还是多次测量的平均值、评价者视为固定还是随机、是否存在系统偏差,分别对应不同模型。报告时必须说明所用模型与计算方式,否则结果难以比较。

常参考的分档为:小于0.50为差;0.50~0.75为中等;0.75~0.90为良好;大于0.90为优。ICC同时受个体间变异与测量误差影响,样本的个体间差异过小会低估ICC,因此选入的受试对象应能覆盖目标人群的测量范围。

常见形式中,ICC(1,1)适用于每名受试者由不同评价者测量、评价者不固定且不要求系统偏差一致的情形;ICC(2,1)假定评价者是从更大评价者总体中随机抽取,允许存在系统偏差,结果可外推;ICC(3,1)把评价者视为固定,只关注当前这几名评价者的一致性。三者数值往往不同,研究目的决定了应选用哪一种。

五、医学实例:测量信度

两名医生分别用同一量表对20名患者的症状评分(0~100分)进行测量,数据见表2。

患者编号医生A医生B
15254
26159
34749
47068
55556
66361
74547
85860
96664
105052
117270
125755
134951
146466
155351
166869
174644
186062
195657
206260

采用双向随机效应的单次测量模型计算,ICC(2,1)=0.97(95%CI:0.93~0.99,P<0.001),提示两名医生的评分一致性为优。整体测量标准差约7.7分,按ICC折算的测量标准误约为1.3分,最小可检测变化约为3.6分,即评分变化小于该幅度时可能只是测量误差所致。

六、常见错误用法

  • 用Kappa评价连续变量的一致性,或用ICC评价分类资料。
  • 只报告Kappa或ICC数值,不说明所用模型、加权方式与置信区间。
  • 把一致性当作准确性:一致性高只说明结果可重复,不代表结果正确。
  • 受试对象个体间差异过小时计算ICC,得到偏低的信度。
  • Kappa接近0时直接断言"完全无关",忽视边缘分布的影响。
  • 用线性相关系数代替ICC评价一致性,相关系数对系统偏差不敏感。

七、注意事项

一致性研究应预先规定测量方法、评分标准与样本量,受试对象应覆盖目标人群的测量范围。Kappa与ICC都依赖研究样本,样本量越大,估计越稳定;报告置信区间有助于判断一致性的精度。此外,一致性只是测量学性质之一,还应结合重测信度、评定者间信度以及测量误差共同评价量表或仪器的表现。报告时宜同时给出原始一致率、Kappa及其95%置信区间,或ICC模型、数值及其95%置信区间,并结合专业标准判断一致性是否满足使用要求。

卡方检验医学实例4-配对列联表资料卡方检验

配对设计R*R的列联表资料(R>2)使用Bowker检验,当R=2时,等同于McNemar检验。 对于配对设计两分类资料,经典的方法是使用四格表的配对检验,也称McNemar检验。而对于配对设计多分类资料,可以使用Bowkor检验。该检验由A.H.Bowkor在1948年提出。Bowker检验也称平方表检验或对称检验,是McNemar检验的一般化及扩展。

一、Bowkor检验计算公式

自由度df=k(k-1)/2,如果有对称的两个单元格之和为0,则在公式中排除,自由度也相应的要减少。

二、医学应用实例

为了比较试剂A与试剂B在糖尿病检测中的有效性,我们招募了100名患者,并对他们使用试剂A和试剂B进行了糖尿病检测。这些检测结果被分为三类:阴性(未患病)、阳性(轻度患病)和重度阳性(重度患病)。以下是收集到的3x3数据表:

试剂B 阴性试剂B 阳性试剂B 重度阳性
试剂A 阴性4050
试剂A 阳性10305
试剂A 重度阳性055

这个表格中的数据反映了试剂A和试剂B在不同患者群体中的表现。行表示试剂A的结果,列表示试剂B的结果。代入公式计算出卡方值等于1.67,因为有对称两个单元格之和等于0,所以自由度=(3*(3-1)/2)-1=2,查卡方界值表得P>0.05,表明两种试剂没有显著性差异。

三、使用软件计算配对列联表资料卡方检验

本软件提供该分析功能。

医学统计助手(www.statsas.com)