配对设计R*R的列联表资料(R>2)使用Bowker检验,当R=2时,等同于McNemar检验。 对于配对设计两分类资料,经典的方法是使用四格表的配对检验,也称McNemar检验。而对于配对设计多分类资料,可以使用Bowkor检验。该检验由A.H.Bowkor在1948年提出。Bowker检验也称平方表检验或对称检验,是McNemar检验的一般化及扩展。
一、Bowkor检验计算公式
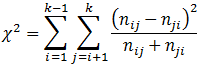
自由度df=k(k-1)/2,如果有对称的两个单元格之和为0,则在公式中排除,自由度也相应的要减少。
配对设计R*R的列联表资料(R>2)使用Bowker检验,当R=2时,等同于McNemar检验。 对于配对设计两分类资料,经典的方法是使用四格表的配对检验,也称McNemar检验。而对于配对设计多分类资料,可以使用Bowkor检验。该检验由A.H.Bowkor在1948年提出。Bowker检验也称平方表检验或对称检验,是McNemar检验的一般化及扩展。
一、Bowkor检验计算公式
自由度df=k(k-1)/2,如果有对称的两个单元格之和为0,则在公式中排除,自由度也相应的要减少。
卡方检验(Chi-Square Test)是一种用于检验观察数据与理论预期之间差异是否显著的统计方法。在医学研究中,卡方检验特别适用于分析分类数据,例如疾病的发病率、治疗效果以及不同因素之间的关系。
一、卡方检验的原理
卡方检验用于判断观察到的频数与预期频数之间的差异是否显著。其基本假设是:观察到的分布与预期分布无显著差异,即变量之间没有关联。卡方统计量的基本公式为:
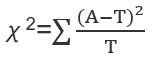
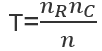
自由度df=(行数-1)(列数-1)
二、四格表(2x2表)的结构
Cochran Q检验是一种非参数统计方法,用于比较三个或更多相关样本中的二分类变量(如成功/失败、通过/未通过等)的比例。Cochran Q检验是Friedman检验在二分类情况下的特殊情况,它主要应用于重复测量设计或随机区组设计。Cochran Q检验旨在检测在不同条件下,受试者的二分类响应是否存在显著差异。
假设对比三种不同的止痛药对慢性头痛患者缓解症状的效果。随机选择了20名诊断为慢性头痛的患者。为了比较三种止痛药的效果,将每个患者分配到三个阶段的治疗,每个阶段为2周,中间有一个为期2周的洗脱期。三种止痛药包括:止痛药A、止痛药B、止痛药C。在每个阶段结束时,记录患者的头痛症状是否得到有效缓解(成功或失败)。1表示成功,0表示失败。表格中是收集到的数据。
为了确定三种止痛药的疗效有无显著性差异,可以使用Cochran Q检验计算Q值和P值。如果P值小于预先设定的显著性水平(例如0.05),就可以拒绝H0(所有止痛药的疗效相同),并得出结论:至少有一种止痛药的疗效与其他止痛药不同。
卡方检验(chi-squared test)是用于比较观察数据和期望数据之间的差异是否显著的一种统计方法。在进行卡方检验时,需要计算卡方统计量和p值,并将这些结果与显著性水平进行比较,来判断差异是否具有统计学意义。
卡方检验结果通常包括卡方统计量、自由度和显著性水平(P值):
卡方检验是一种常用的统计学方法,主要用于检验分类变量之间的关系。然而,在实际应用中,有时会出现一些错误用法。以下是卡方检验中更详细的常见错误及如何避免它们:
1.样本量太小:卡方检验依赖于足够的样本量,以确保检验结果的准确性。如果观察次数太少,检验结果可能受到偶然因素的影响。通常建议每个单元格的期望计数至少为5。如果样本量较小,可以考虑使用Fisher精确检验等其他方法。
2.连续变量的错误使用:卡方检验主要用于分类变量,将连续变量简单地划分为类别可能会导致信息损失和误差。对于连续变量,应使用其他方法,如t检验、方差分析或相关分析。若要将连续变量用于卡方检验,可以使用合适的分箱策略,但要谨慎处理分箱边界。
样本含量是在进行研究时所需的样本大小或参与者数量。在研究设计中,样本含量的大小直接影响研究的统计功效和可靠性。样本含量的大小取决于多个因素,如研究目的、研究设计、效应或关系的大小和统计分析方法等。确定适当的样本大小可以确保研究的有效性,并最大程度地减少Ⅰ类错误和Ⅱ类错误的概率。
一、两类错误:
1.第一类错误(Ⅰ类错误)也称为α错误,指的是原假设是正确的,但被错误地拒绝了。举例来说,在法庭判案中,如果被告真的是无辜的,但法官错误地判定被告有罪,那么这就是一种第一类错误。置信度为1-α。
2.第二类错误(Ⅱ类错误)也称为β错误,指的是原假设是错误的,但被错误地接受了。举例来说,在法庭判案中,如果被告真的是罪犯,但法官错误地判定被告无罪,那么这就是一种第二类错误。检验效能又称把握度,为1-β。
游程检验是一种统计方法,用于检测数据序列中的随机性。在许多领域,如金融、气象学、生物学和社会科学等,都需要评估观测数据是否具有随机性。随机性是许多领域研究的基础。对数据序列的随机性进行检验有助于判断数据是否受到某种系统性影响,或者是否具有某种潜在的模式。游程检验是一种常用的随机性检验方法,其基本思想是分析数据序列中连续相同值的子序列的长度(即游程),以判断整个序列是否具有随机性。
一、游程检验在医学统计中的应用:
在医学统计中,评估数据序列的随机性具有重要意义。通过检验数据的随机性,可以判断实验结果是否受到某种系统性误差的影响,以及评估患者生理信号的稳定性和异常。例如实验设计、生物信号分析、疫情分析等等方面。
在统计学中,假设检验是评估某种特定情况下观察到的数据是否符合假设的一种方法。t检验和Z检验是两种常用的假设检验方法,分别用于比较均值差异以及比例差异。在医学统计中,t检验和Z检验经常被用于研究和比较不同治疗方法的效果,例如药物疗效、手术效果等。t检验和Z检验应用起来容易混淆,下面介绍下它们的区别。
一、t检验
t检验是用于比较两个总体的均值之间是否存在显著差异。在进行t检验时,不知道总体的标准差,而是使用样本标准差代替。t检验基于t分布,其形状与正态分布相似,但是在尾部较厚。随着样本量的增加,t分布逐渐接近正态分布。
t检验通常用于以下场景:1.比较两个独立样本的均值;2.比较两个配对样本的均值差异;3.验证样本均值与已知的总体均值之间是否存在显著差异;4.分析某一变量的变化是否显著。
实例1
在医学统计中,相关分析是一种常用的方法,用于研究两个或多个变量之间的关系。使用相关分析可发现变量之间的线性或非线性关系,为后续的实验设计、临床研究和治疗策略提供依据。
常用相关分析方法有:
1.皮尔逊相关分析(Pearson Correlation),用于衡量两个连续变量之间的线性关系。皮尔逊相关系数(r)的取值范围为-1至1。r=1表示完全正相关,r=-1表示完全负相关,r=0表示无相关。
2.斯皮尔曼等级相关分析(Spearman Rank Correlation),用于衡量两个变量之间的单调关系,主要用于非线性关系或非正态分布数据。它通过计算原始数据的等级差异来评估关系,因此对异常值和数据分布较为稳健。
3.肯德尔等级相关分析(Spearman Rank Correlation),与斯皮尔曼等级相关分析类似,也是用于衡量两个变量之间的单调关系。它基于变量之间的配对观测值的一致性或不一致性来计算相关性。相对于斯皮尔曼相关,肯德尔相关对异常值更为稳健。
多元线性回归分析是医学统计学中最常用的方法之一。在医学领域,通常使用多元线性回归来研究各种健康相关因素(例如血压、血糖、血脂等)之间的关系,并确定哪些因素对健康状况的影响最大。还可以用于预测某些因素对某种疾病或健康状况的影响。例如,要确定高血压的风险因素,可以使用多元线性回归来分析不同的因素(例如体重、饮食习惯、吸烟等)对高血压的影响,以便更好地了解高血压的发病机制,从而更有效地预防和治疗高血压。还可以用来研究药物治疗效果,使用多元线性回归来确定药物治疗的效果,例如治疗某种疾病后,血糖、血脂等生理指标的变化情况。
使用多元线性回归分析来研究患者的生活方式因素对胆固醇水平的影响。以年龄、体重指数(BMI)、每周运动时间和膳食纤维摄入量对总胆固醇(Total Cholesterol, TC)的影响。总胆固醇以mmol/L为单位表示。
示例数据仅做演示: